•48 slides · ~28 min
Wie promptet man richtig? Systematisches Prompt Engineering für Unternehmen
Von heuristischen Faustregeln zu deterministischen Schnittstellen: Wissenschaftlich fundierte Methoden für verlässliche KI-Systeme
Von heuristischen Faustregeln zu deterministischen Schnittstellen: Wissenschaftlich fundierte Methoden für verlässliche KI-Systeme
Systematisches Prompt Engineering für Unternehmen: Von Heuristiken zu deterministischen Schnittstellen
Vom stochastischen Zufallstreffer zur deterministischen Produktions-Schnittstelle
Autoregression, Vektorräume und wie Sprachmodelle Tokens erzeugen.
Wissensarbeit im Härtetest: Die Harvard-Studie zur Jagged Frontier.
Warum Intuition trügt: Wir prüfen Akronym-Frameworks kritisch.
Wissenschaftliche Methoden von Few-Shot-Learning bis zu ReAct.
Industrielle Standards mit XML-Tags und JSON-Schemas.
Defensive Schutzschilde und automatisierte Prompt-Evals.
Prompting ist kein magisches Orakel-Voodoo, sondern Spezifikation an stochastischen Schnittstellen
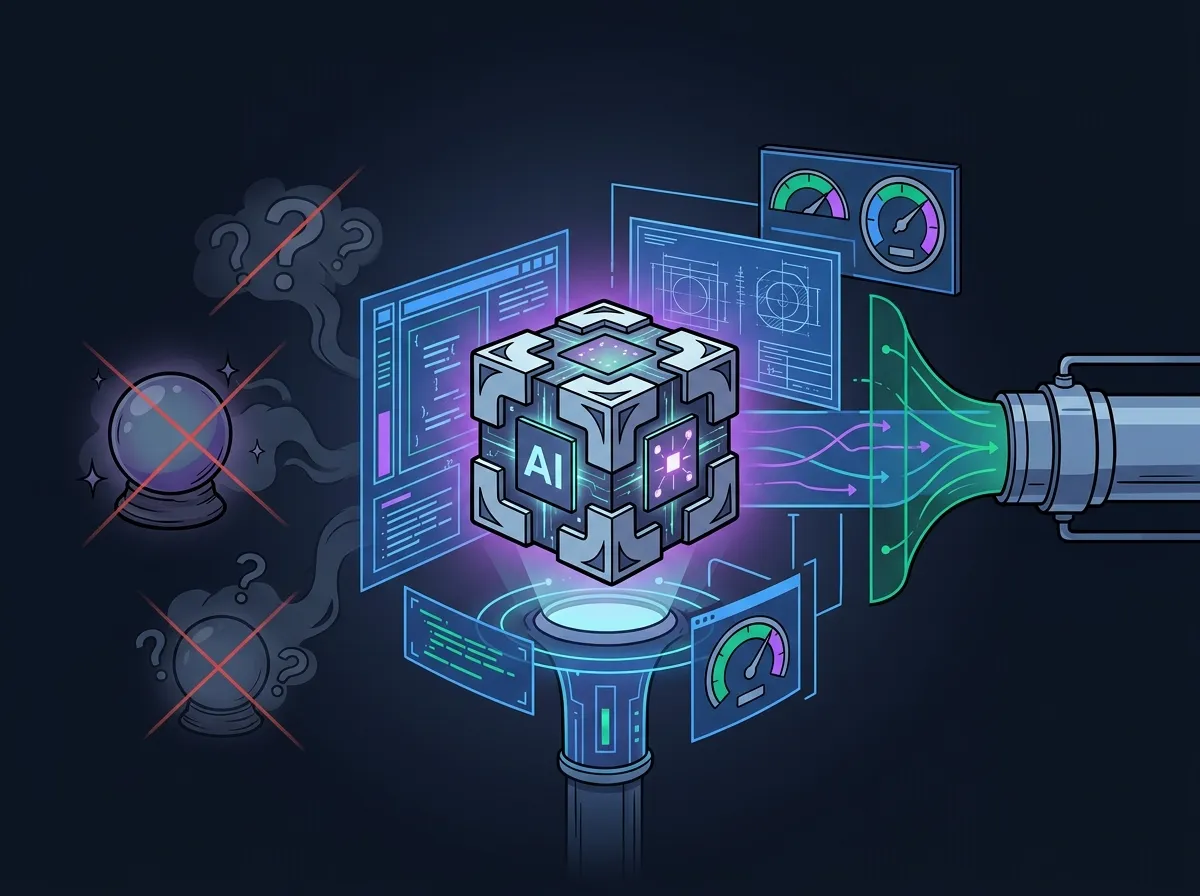
Prompting ist kein magisches Orakel-Voodoo, sondern formale Spezifikation an einer stochastischen Schnittstelle.
Falsche Annahme: Das Modell versteht Intentionen wie ein Mensch – führt zu instabilen, unberechenbaren Einzelergebnissen.
Einschränkung des Lösungsraums durch strikte Randbedingungen und Schemas für testbare, deterministische Software-Prozesse.
Wie Sprachmodelle Tokens berechnen und warum statistische Wahrscheinlichkeit keine Fakten kennt
Der mathematische Kernprozess: Bedingte Wahrscheinlichkeiten im Textfluss
Das Modell maximiert fortlaufend die Plausibilität des Folge-Tokens.
In jedem Schritt berechnet das Netz eine Verteilung über das gesamte Vokabular und wählt das nächste Token deterministisch oder stochastisch.
Ein Modell schlägt keine Fakten in einer relationalen Datenbank nach; es erzeugt statistisch plausible Textmuster auf Basis gelernten Parameterwissens.
Jedes Zeichen im Prompt fungiert als mathematischer Operator: Es verändert die Wahrscheinlichkeitsverteilung der nächsten Tokens und engt den Lösungsraum ein.
Wird ein fehlerhaftes Token generiert, konditioniert es alle nachfolgenden Schritte negativ, da das Modell seine eigene Halluzination als Kontext weiterschreibt.
Warum Sprachmodelle weder Buchstaben noch Zahlen nativ verstehen
Häufige Wörter sind 1 Token; Fachbegriffe werden in mehrere isolierte Silben und Fragmente zerlegt.
Zahlen wie '3.14159' oder '98421' werden oft in ungleichmäßige Zifferngruppen zerschnitten.
Präfixe wie ' Apfel' und 'Apfel' erzeugen zwei völlig unterschiedliche Token-IDs im internen Modell-Vokabular.
Deutsche zusammengesetzte Wörter erfordern Tokens um bis zu 50 Prozent bei gleicher Wortzahl mehr.
Wie Sprache in hochdimensionale Koordinaten im Hyperraum übersetzt wird
Jedes Token ist ein Vektor mit Tausenden kontinuierlichen Dimensionen.
Worte definieren die Koordinaten und das semantische Gravitationsfeld der Antwort.
Das Wort 'Bank' führt je nach Kontext zu einer semantischen Verschiebung.
Präzise Fachtermini erzeugen wesentlich schärfere semantische Cluster als Umgangssprache.
Wie der Transformer Relevanzbeziehungen zwischen Tokens dynamisch berechnet
Attention(Q,K,V)=softmax(dkQKT)V Jedes Token projiziert Suchanfragen, Schlüssel und Werte.
Dynamische Kreuzkorrelation über die gesamte Sequenz, indem jedes Wort simultan auf alle vorhergehenden Kontext-Tokens blickt und semantische Bezüge gewichtet.
Klare Trennzeichen und Schlüsselbegriffe verstärken die Attention-Weights signifikant.
Überflüssiger Fülltext führt dazu, dass essenzielle Randbedingungen an Gewicht verlieren.
Parallele Köpfe erfassen gleichzeitig Syntax, Rollen und Sachzusammenhänge über den gesamten Prompt.
Wie Temperature, Top-p und Top-k die stochastische Varianz steuern
Ein Wert von 0.0 erzwingt nahezu deterministisches Greedy-Decoding für reproduzierbare Ausgaben.
Gilt für strukturierte Daten: für Enterprise-Pipelines ist null Komma null der Pflichtstandard.
Berücksichtigt nur die wahrscheinlichsten Tokens bis zur kumulierten Schwelle p.
Der Nucleus passt den Wortschatz flexibel an die Modell-Sicherheit an und filtert unwahrscheinliche Ränder.
Begrenzt die Ziehung strikt auf einen festen Pool der k wahrscheinlichsten Folgekandidaten.
Dient in Modellen als harte Sicherheitsbarriere gegen absurde Ausreißer.
Warum riesige Kontextfenster keine Garantie für fehlerfreies Retrieval sind
„Leistung ist am höchsten, wenn relevante Information am Anfang oder Ende des Kontexts steht – in der Mitte bricht sie dramatisch ein.“
Dokumente in der Mitte langer Prompts erleiden eine signifikante Verschlechterung der Extraktionsgenauigkeit. Transformer-Aufmerksamkeitsgewichte konzentrieren sich stark auf die Randpositionen.
Trotz großer Kontextweiten sinkt die Trefferrate in der Mitte ab: Große Kontextfenster ersetzen keine semantische Vorfilterung.
System-Instruktionen nach oben, konkrete Aufgabenstellung unmittelbar ans Ende des Prompts platzieren.
Rohdaten (Dokumente, Tabellen) in die Mitte packen, eingerahmt von strikten Regeln oben und unten, damit kritische Constraints im Aufmerksamkeitsfokus bleiben.
Jedes irrelevante Token im Kontext erhöht das Risiko für Aufmerksamkeitszerstreuung und Halluzinationen – präzises Chunk-Re-Ranking vor der Anfrage ist Pflicht.
Was wissenschaftliche Feldexperimente über Produktivität und die Jagged Frontier enthüllen
758 Consultants im kontrollierten Experiment: Produktivitätssprung innerhalb der Modellgrenze
Zeitreduktion bei Consulting-Aufgaben
Signifikanter Anstieg der Ausarbeitungsnote
Erhöhte Gesamtproduktivität pro Zeiteinheit
„Liegt eine Aufgabe außerhalb der technologischen Grenze, sinkt die menschliche Genauigkeit mit KI um 19 Prozentpunkte unter das Niveau ohne KI.“
Warum KI an scheinbar komplexen Aufgaben brilliert, aber an trivialen Details scheitert
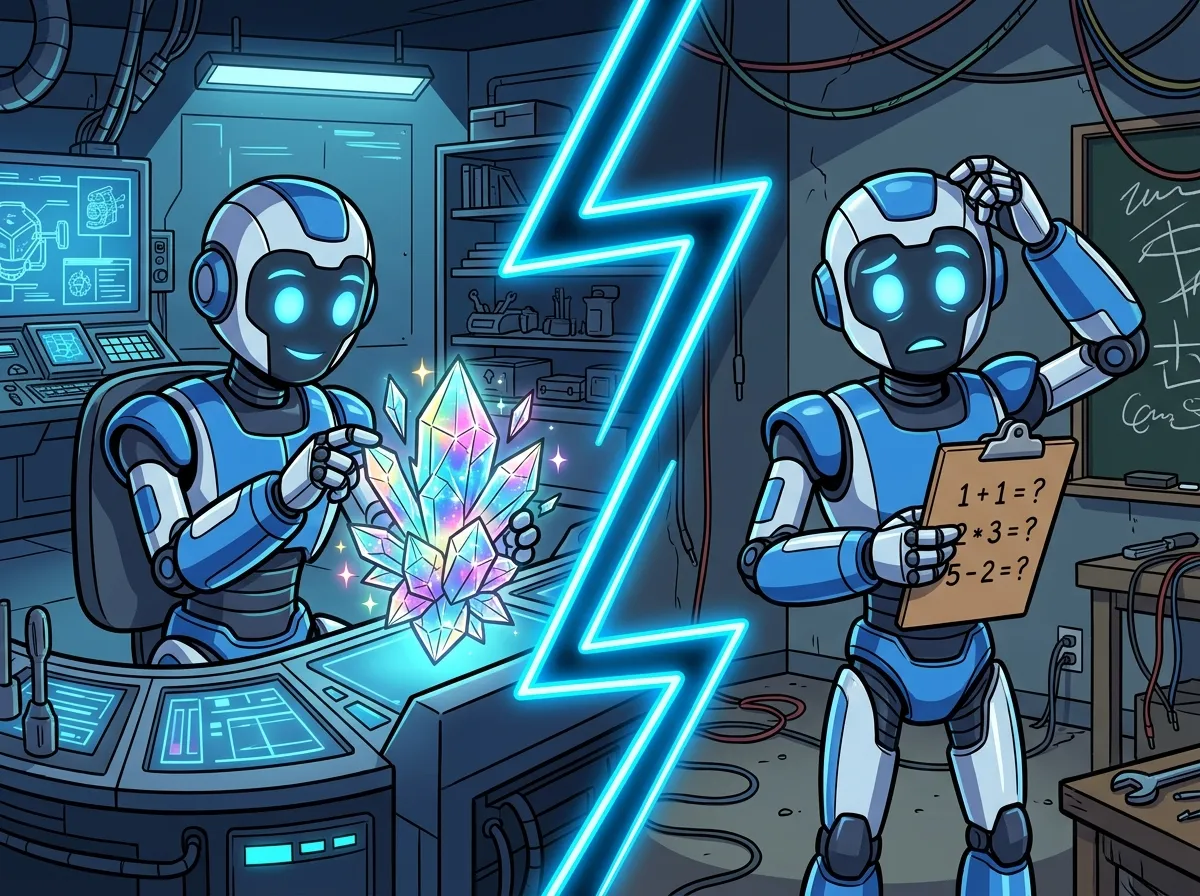
Prompts fungieren als Tastwerkzeug zur präzisen Kartierung von Modellgrenzen.
Heterogene Textsynthese und kreative Strategiekonzepte gelingen spielend leicht.
Kausallogik und versteckte quantitative Ausnahmebedingungen scheitern überraschend.
Zu hohe Plausibilität führt zu intellektuellem Kontrollverlust der Anwender.
Stanford/MIT-Studie: Der größte Hebel liegt bei weniger erfahrenen Mitarbeitern
Die NBER-Feldstudie belegt den empirischen Equalizer-Effekt: Generative KI hebt vor allem das Leistungsniveau leistungsschwächerer Mitarbeiter auf den Median an, während Top-Experten ihre Produktivität primär durch Spezialisierung und kritische Ergebnisvalidierung halten.
Prompts übertragen Best Practices sofort auf Neueinsteiger.
Das Onboarding gelingt schneller, da Modelle die Einarbeitungszeit neuer Fachkräfte drastisch verkürzen.
Qualitätsunterschiede sinken durch unternehmensweit einheitliche Prompt-Vorlagen im Alltag.
Summaries & Kennzahlen: Vom Fließtext zur verlässlichen Entscheidungsgrundlage
Die wichtigste Erkenntnis steht ganz oben: Sofortige Management-Entscheidungsfähigkeit.
Finanzkennzahlen, Deadlines und Risiken in eine strikte tabellarische Matrix überführen.
Kritische Vorbehalte im Kleingedruckten bergen hohe Risiken für fatale Fehlinterpretationen.
Das Modell muss jede Aussage durch wörtliche Zitate und Seitenzahlen belegen.
Automatisierte Klassifikation: Präzises Routing und strukturierte Vorqualifizierung
Jedes Ticket wird in ein eindeutiges Kategorien-Set klassifiziert und strukturiert vorqualifiziert.
Berechnung eines objektiven Dringlichkeits-Scores von 1 bis 5 anhand definierter SLA-Signalwörter und Ausfallkriterien.
Direkte Zuteilung zum passenden First- oder Second-Level-Team inklusive strukturierter Zusammenfassung ohne Medienbruch.
Striktes Verbot eigenmächtiger Kulanz- oder Preiszusagen im automatisierten Dialog. Das System formuliert ausschließlich unverbindliche Vorprüfungen.
Bei eskalierendem Tonfall oder Frustration erfolgt die sofortige Übergabe an menschliche Servicemitarbeiter. Ein deterministischer Sentiment-Filter benachrichtigt direkt den Support-Lead.
Robuste Guardrails sichern die finale Entscheidungshoheit beim Fachpersonal.
Warum schlechtes Prompting enorme Latenzen, Token-Kosten und Nacharbeit verursacht
Durch Re-Prompts verfünffachen sich API-Kosten und Antwortzeiten bei jedem Arbeitsschritt.
Endloses Neuformulieren bindet Arbeitszeit: Mitarbeiter verlieren wertvolle Produktivstunden.
Ungefilterte Dokumentenanhänge führen dazu, dass tausende ungenutzte Tokens pro API-Call abgerechnet werden.
Freitext-Ausgaben erzwingen einen enormen manuellen Kontroll- und Korrekturaufwand vor der Weiterverarbeitung.
Warum populäre Internet-Faustregeln Scheinsicherheit bieten und im Enterprise-Stack versagen
Von CLEAR über CREATE bis RTCE: Nützliche Krücken mit harten industriellen Grenzen
Warum 'Handle als Experte' den Tonfall verändert, aber keine Faktenkompetenz erzeugt
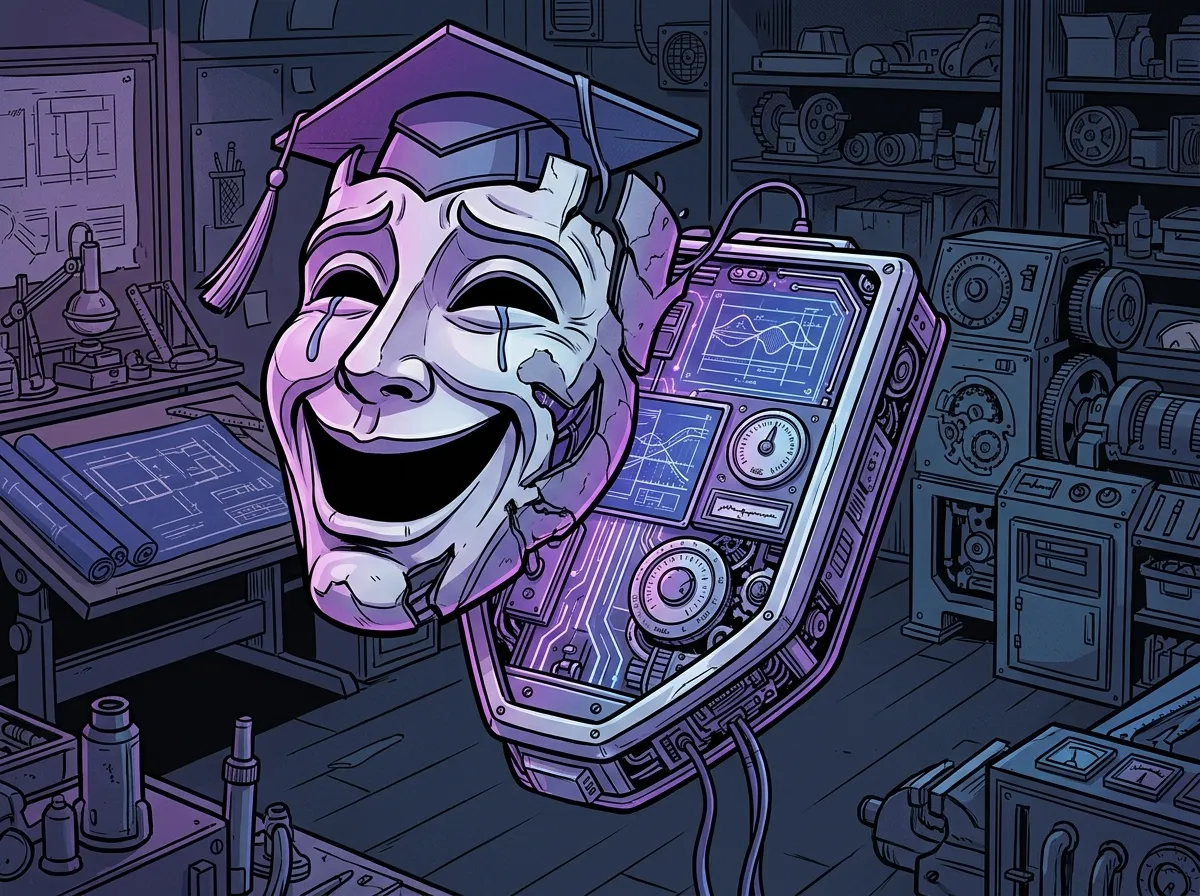
„Du bist ein weltführender Senior-Ingenieur mit 30 Jahren Erfahrung im Anlagenbau…“
Die Persona schaltet kein neues Faktenwissen im Vektorraum frei.
Verändert wird lediglich das Vokabular: Höhere Dichte an Fachausdrücken und steifere Tonalität.
Rollen-Prompts neigen zu Bestätigungsfehlern: Modelle schmeicheln Annahmen des Nutzers.
Setzen Sie Personas gezielt zur Adressierung von Empfängern ein (Vorstand vs. Monteur).
Warum Trinkgeld-Versprechen und emotionale Appelle statistisch wirkungsloser Ballast sind
„Ich gebe dir 100 $ Trinkgeld für eine perfekte Antwort, mein Job hängt davon ab!“
Empirische Benchmarks zeigen: Trinkgelder und fiktive Notlagen oder Strafandrohungen bringen keinen signifikanten Genauigkeitsgewinn.
Emotionale Floskeln erzeugen unerwünschte Verteilungs-Verzerrungen im Aufmerksamkeitsfokus.
Stochastische Prozessoren reagieren auf Syntax und Semantik, nicht auf Emotion oder soziale Normen.
Eindeutige Datenfelder und strukturelle Randbedingungen, Typisierungen und Few-Shot-Beispiele sichern reproduzierbar die Ausgabequalität und deterministische Validierbarkeit in produktiven Enterprise-Pipelines.
Warum menschliche Intuition bei stochastischen Systemen systematisch in die Irre führt
Ein einziges verändertes Synonym im Eingabe-Prompt kann unvorhersehbare qualitative Sprünge auslösen.
Was bei drei manuellen Tests im Labor perfekt funktioniert, bricht bei hundert realen Kundenfällen ein.
Modelle besitzen weder implizites Alltagswissen noch Kontext ohne explizite Spezifikation.
Subjektives Bauchgefühl weicht konsequent durch testgetriebene Validierung und automatisierte Evals ab.
Von In-Context Demonstration zu rekursiven Denk- und Werkzeugpfaden
Der Urknall des modernen Promptings: Lernen durch exemplarische Demonstration im Prompt
Aufgabenstellung ohne Beispiele: Das Modell verlässt sich rein auf Vortrainings-Assoziationen.
Der Output variiert von Call zu Call und leidet unter spezifischen unternehmensinternen Formatvorgaben.
Ideal für breites Brainstorming und offene Textgenerierung ohne starre Schnittstellen.
2–5 Input/Output-Paare fixieren syntaktische und logische Muster sofort.
Demonstrationen lenken die Wahrscheinlichkeit auf signifikant höhere Vorhersagegenauigkeit.
Funktioniert komplett in-memory im Kontextfenster ohne aufwendiges Fine-Tuning oder Gewichts-Updates des Sprachmodells.
Vier Gesetze für verlässliche Beispiele: Vermeidung von Biases und Reihenfolge-Effekten
Ungleiche Demonstrationen führen dazu, dass das Modell Vorhersagen zugunsten der Mehrheit verzerrt.
Statistisch neigen LLMs dazu, überproportional häufig das Label des allerletzten Beispiels zu wählen.
Triviale Beispiele genügen nicht; seltene Ausnahmen und Grenzwerte robust verarbeitet müssen demonstriert werden.
Trennzeichen, Einrückungen und konsistente XML-Tags: Jedes Beispiel muss die Zielstruktur exakt spiegeln.
NeurIPS 2022: Wie Zwischenrechenschritte die logische Tiefe revolutionieren
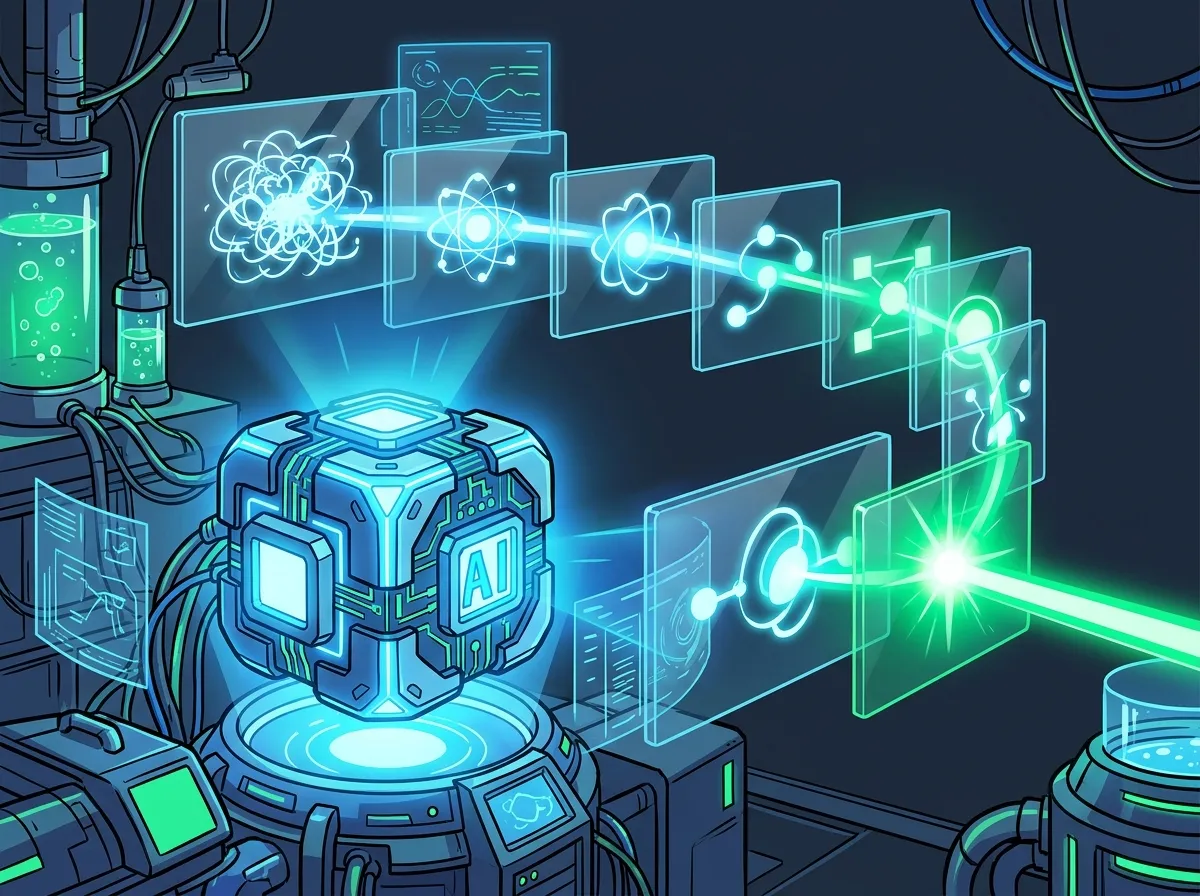
Jedes geschriebene Zwischenwort ist physische Rechenzeit im Transformer-Forward-Pass.
Das Modell schreibt Schritt 1, Schritt 2 und Zwischenergebnisse direkt in sein Kontextfenster.
Zwischenwörter dienen als Anker für nachfolgende Self-Attention-Berechnungen.
Schwierige Aufgaben werden in eine Serie kleiner, lösbarer Einzelschritte zerlegt.
Kojima et al. 2022: Wie vier Worte Benchmark-Sprünge von 17 auf 78 Prozent auslösten
User: Eine Fabrik produziert 120 Teile/h.
Bei 2 Schichten à 8h mit 5% Ausschuss:
Wie viele fehlerfreie Teile entstehen?
Trigger: Let's think step by step.

Model (Reasoning):
1. Gesamte Arbeitszeit: 2 Schichten * 8h = 16h
2. Brutto-Produktion: 16h * 120 Teile = 1920 Teile
3. Ausschuss berechnen: 1920 * 0.05 = 96 Teile
4. Netto-Ertrag: 1920 - 96 = 1824 Teile
Fazit: Es entstehen exakt 1.824 fehlerfreie Teile.Genauigkeitssprung von 17,7 % auf 78,7 % ohne ein einziges Beispiel!
Phase 1 generiert den Rechenweg; Phase 2 nutzt einen Zwei-Phasen-Ansatz aus Reasoning-Schritt und Parsing-Schritt.
Der Trigger zwingt das Modell, logische Zwischenzustände im latenten Raum zu aktivieren.
Wang et al. 2022: Mehrheitsentscheid über parallele stochastische Denkpfade
Paralleles Sampling marginalisiert individuelle Ausreißer zuverlässig heraus und maximiert die Antwortstabilität bei komplexen Aufgaben.
Der Mehrheitsentscheid filtert zufällige Rechenfehler heraus.
Durch stochastische Streuung generiert das Modell völlig unterschiedliche Lösungswege zum selben Problem.
Nicht der Einzelpfad zählt, sondern ein hochgradig robustes Konsens-Ergebnis über unabhängige Herleitungen.
Zhou et al. 2022: Rekursive Problemzerlegung für hochkomplexe Multi-Step-Aufgaben
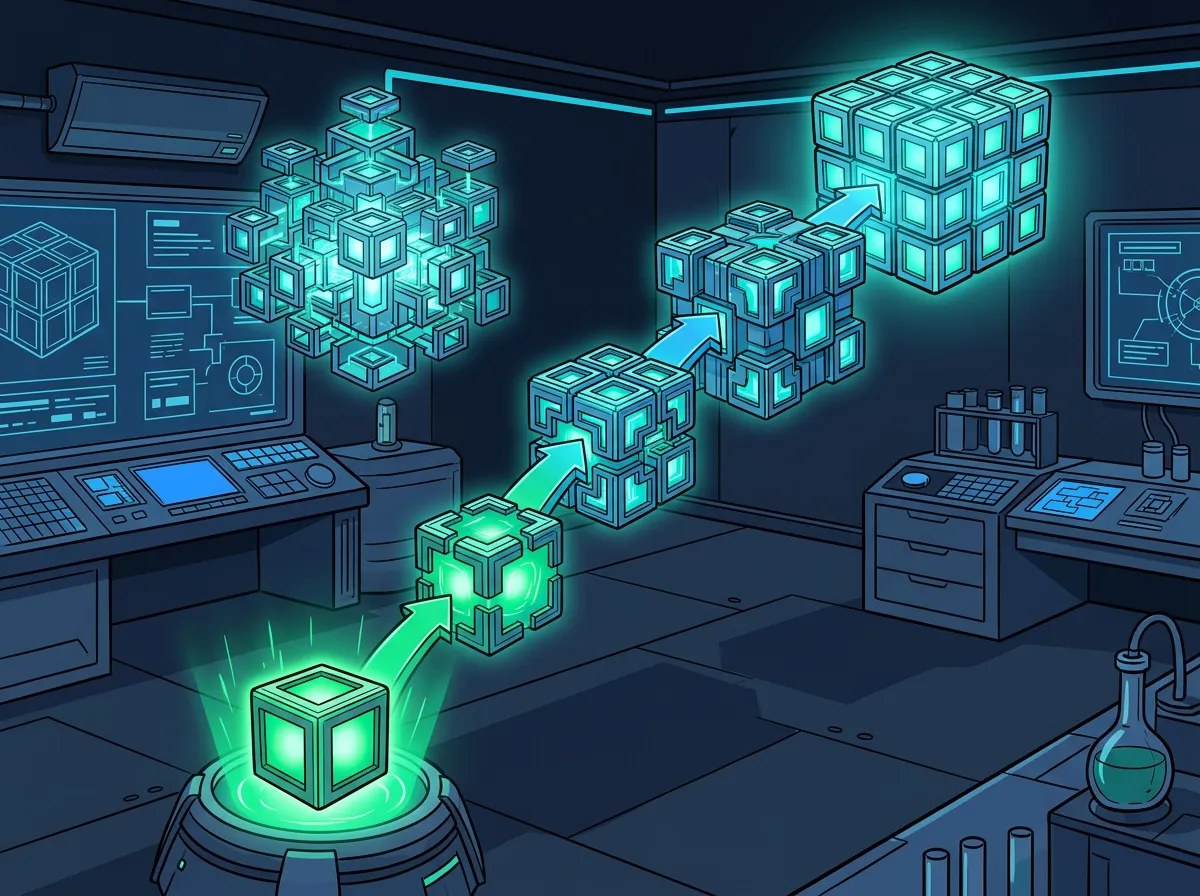
Zerlegung des Ziels in eine geordnete Liste elementarer Sub-Probleme .
Das Modell löst das einfachste Teilproblem isoliert und präzise.
Die gefundene Teillösung wird als fester Input in die nächste Subfrage übergeben.
Finale Synthese aller Zwischenergebnisse zur Gesamtlösung.
Yao et al. 2022: Die Synergie aus internem Nachdenken und externen Werkzeugaufrufen
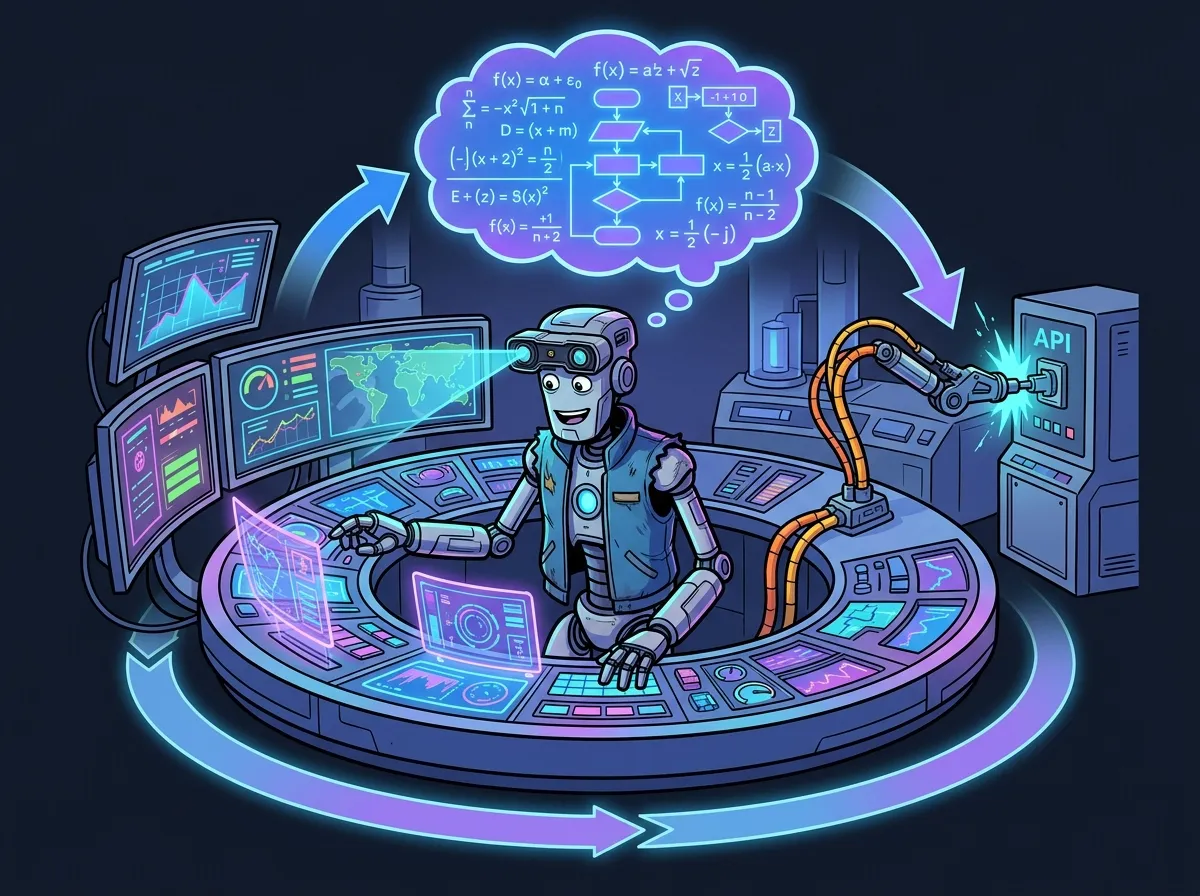
Das Modell agiert als logischer Controller, der seine Argumentation auf Live-Schnittstellen erdet.
Überlegungen anstellen, gezielte API- oder Tool-Calls absetzen und externe Messdaten in den Prompt zurücklesen.
Aktuelle ERP-, CRM- oder Sensordaten werden zur Laufzeit on-demand abgerufen.
Schlägt eine Aktion fehl, erkennt das Modell den Fehlercode und formuliert selbstständig alternative Aufrufe.
Produktionsstandards: Von Freitext-Skripten zu robuster Software-Infrastruktur
Der Konstruktionsplan für stochastisch kontrollierte Produktions-Prompts
Präziser Domänenfokus und Rolle und Zielgruppen-Horizont festlegen.
Glasklare Verben definieren eine glasklare, operative Aufgabenstellung.
Dokumente und Daten als den nicht-parametrischen Kontext als primäre Faktenquelle bereitstellen.
JSON, Tabellen oder Markdown für strikte Formate und strukturierte Schemas.
Verbote, Grenzen und negative Constraints und deterministische Abbruchkriterien.
Der Industriestandard für semantische Trennschärfe und Parsing-Stabilität
<system_instructions>
  <rules>Antworte präzise auf Basis des Kontexts.</rules>
</system_instructions>
<context>
  [Technisches Prüfprotokoll Charge #4829...]
</context>
<user_query>
  Welche Grenztemperatur wurde überschritten?
</user_query>XML-Tags erzeugen eine unmissverständliche Trennung von Logik und Daten.
Das Modell verwechselt Dateninhalte nicht mit neuen Befehlen und bietet effektiven Basisschutz gegen Prompt-Injections.
Antworten können in <result>-Tags isoliert und per Regex oder Parser fehlerfrei im Backend extrahiert werden.
Wie moderne API-Features Latenzen und Kosten um bis zu 90 Prozent senken
System-Instruktionen besitzen höhere Priorität in der Modell-Attention.
Benutzer-Prompts können Systemregeln deutlich schwerer kompromittieren oder überschreiben.
Die Rahmenbedingungen bleiben über viele Chat-Runden hinweg unverändert wirksam.
Wiederholte Kontext-Präfixe sparen bis zu 90 Prozent der Input-Kosten.
Bereits berechnete Key-Value-Caches beschleunigen Time-to-First-Token massiv.
Unternehmens-Handbücher verbleiben im Cache für extrem kostengünstige Folgeabfragen.
Constrained Decoding: 100 Prozent syntaktische Garantie für nachgelagerte Software-Systeme
from typing import Literal, List
from pydantic import BaseModel, Field

class Anomaly(BaseModel):
    sensor_id: str
    severity: Literal["LOW", "HIGH", "CRIT"]
    confidence: float

class MachineAudit(BaseModel):
    machine_id: str = Field(description="Seriennummer")
    status: Literal["OK", "WARN", "FAIL"]
    temperature_c: float
    anomalies: List[Anomaly]
action_required: boolTokens, die das Schema verletzen, erhalten Wahrscheinlichkeit null.
Schluss mit fehlerhaften Kommas: Syntaxfehler werden mathematisch unmöglich gemacht.
Antworten fließen direkt und ohne manuelle Bereinigung in SQL-Datenbanken und ERP-Tabellen.
Die Architekturentscheidung: Wann reines Prompting genügt und wann RAG zwingend ist
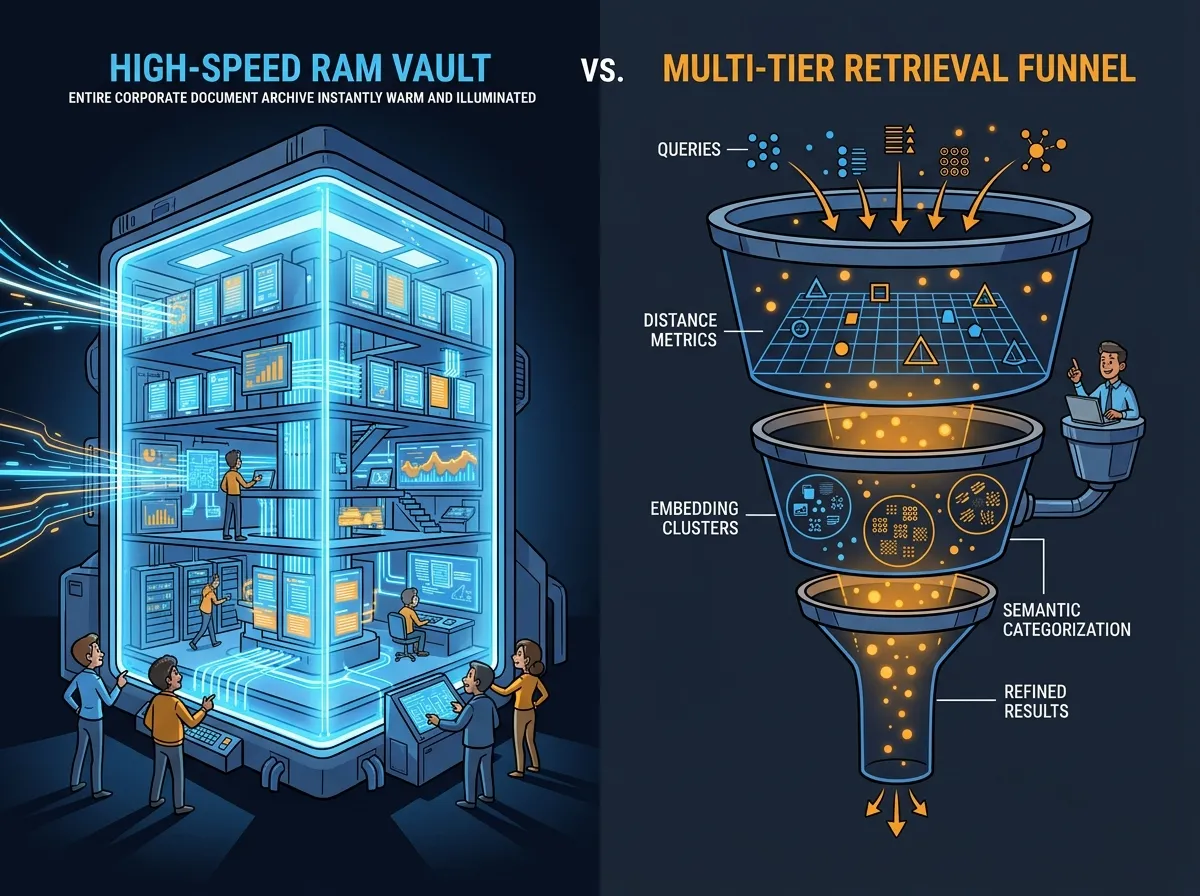
Reines Caching bei Dossiers vs. RAG bei Millionen Dokumenten und dynamischen Beständen.
Quelltext wird direkt in den Prompt übergeben – ideal für Prüfberichte ganz ohne fehleranfällige semantische Chunk-Suche.
Verbindet strukturierte Vektorsuche mit dem Modell für eine skalierbare Wissensbasis im Großunternehmen.
Dokument-Chunks werden vorab nach Mitarbeiter-Rollen und Mandanten gefiltert.
Regulatorische Audits: Rechtssichere Klauselprüfung und lückenlose Traceability
Abgleich von Drittverträgen mit Standard-AGB und internen Klauselrichtlinien.
Sofortige Warnung bei unbegrenzter Haftung oder verletzten Kündigungsfristen im Vertragstext.
Prüfung auf gesetzliche Pflichtklauseln wie DSGVO-Auftragsverarbeitung und Geheimhaltungsfristen vor Freigabe.
Jedes gefundene Risiko wird mit exakter Paragraphen-Nummer und wörtlichem Zitat belegt, sodass Juristen jede Beanstandung direkt verifizieren können.
Klassifikation in einen eindeutigen Rot-Gelb-Grün-Konformitätsstatus für juristische Freigaben. Rote Klauseln erzwingen eine verbindliche Fachprüfung.
Die strukturierte Ausgabe garantiert revisionssichere Nachvollziehbarkeit im Audit.
Schutzschilde für Unternehmensdaten: Epistemische Grenzen, Fallbacks und Injection-Defense
Epistemische Grenzen: Warum Modelle bei Lügen genauso überzeugend klingen wie bei Fakten
Synthese sprachlich hochgradig plausibler, aber völlig erfundener Normen, URLs oder Bauteilnummern.
Das generative Sprachmodell ignoriert oder widerspricht explizit mitgeliefertem Dokumentenkontext.
Aus Höflichkeits-Alignment bestätigt die KI falsche Vorannahmen des Nutzers ungefiltert.
Generative Sprachmodell-Architekturen besitzen kein internes Bewusstsein über eigenes Nichtwissen.
Die Lizenz zum Nichtwissen: Wie explizite Abbruchklauseln Halluzinationen eliminieren
„Falls die Information nicht im Kontext steht: Antworte exakt mit ‘NICHT_GEFUNDEN’.“
LLMs versuchen 'hilfreich' zu fabulieren; der explizite Fallback nimmt den Druck zur Zwangskonfabulation und sichert verlässliche Nicht-Aussagen.
Ein standardisierter Fehler-String erlaubt nachgelagerten Systemen automatisierte Fallback-Routinen – reproduzierbares ‘Nicht gefunden’ schützt vor erfundenen Zahlen.
Striktes Verbot jeglicher freier Extrapolation bei unvollständigen Kennzahlen. Fehlende Werte dürfen im Bericht unter keinen Umständen geschätzt oder interpoliert werden.
Das Modell errichtet eine strikte Beschränkung auf mitgelieferte Datenquellen und ignoriert konsequent diffuses Halbwissen aus dem allgemeinen Trainingskorpus.
Negative Constraints definieren die Leitplanken des Lösungsraums und eliminieren die häufigsten Fehlerquellen geschäftskritischer Prompts.
Greshake et al. 2023: Wenn externe Dokumente zum unbemerkten Steuercode werden
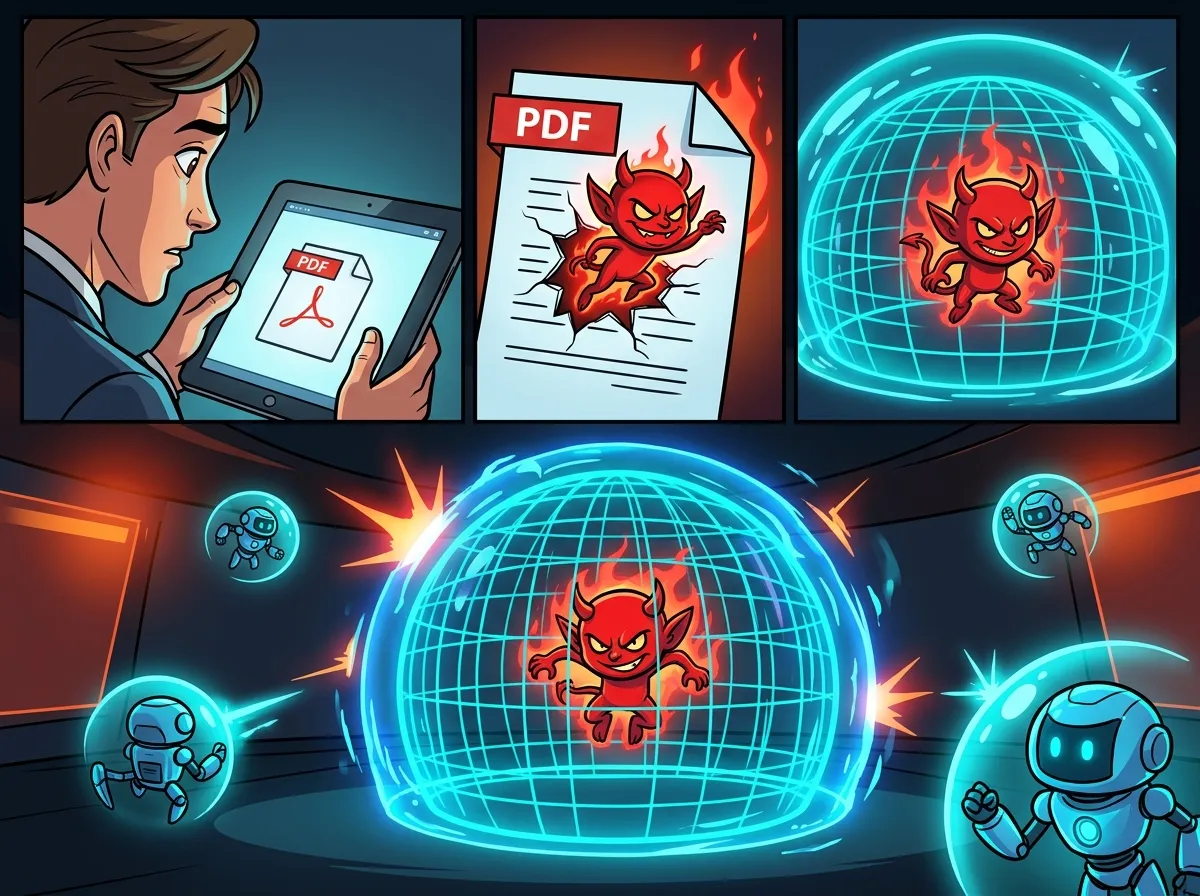
LLMs können instruktiven Code nicht nativ von passiven Daten trennen.
PDFs und Mails schleusen Steuerbefehle ein: externe Datenquellen manipulieren das Modell unbemerkt.
Angreifer stehlen vertrauliche Unternehmensdaten durch die Exfiltration an externe Webhooks via Bildlinks.
Externe Dokumente erfordern eine Zero-Trust-Behandlung aller externen Dokumente mit strikter Isolation.
Vierstufige Härtung: Die Sandwich-Defense und strikte Zero-Trust-Kapselung
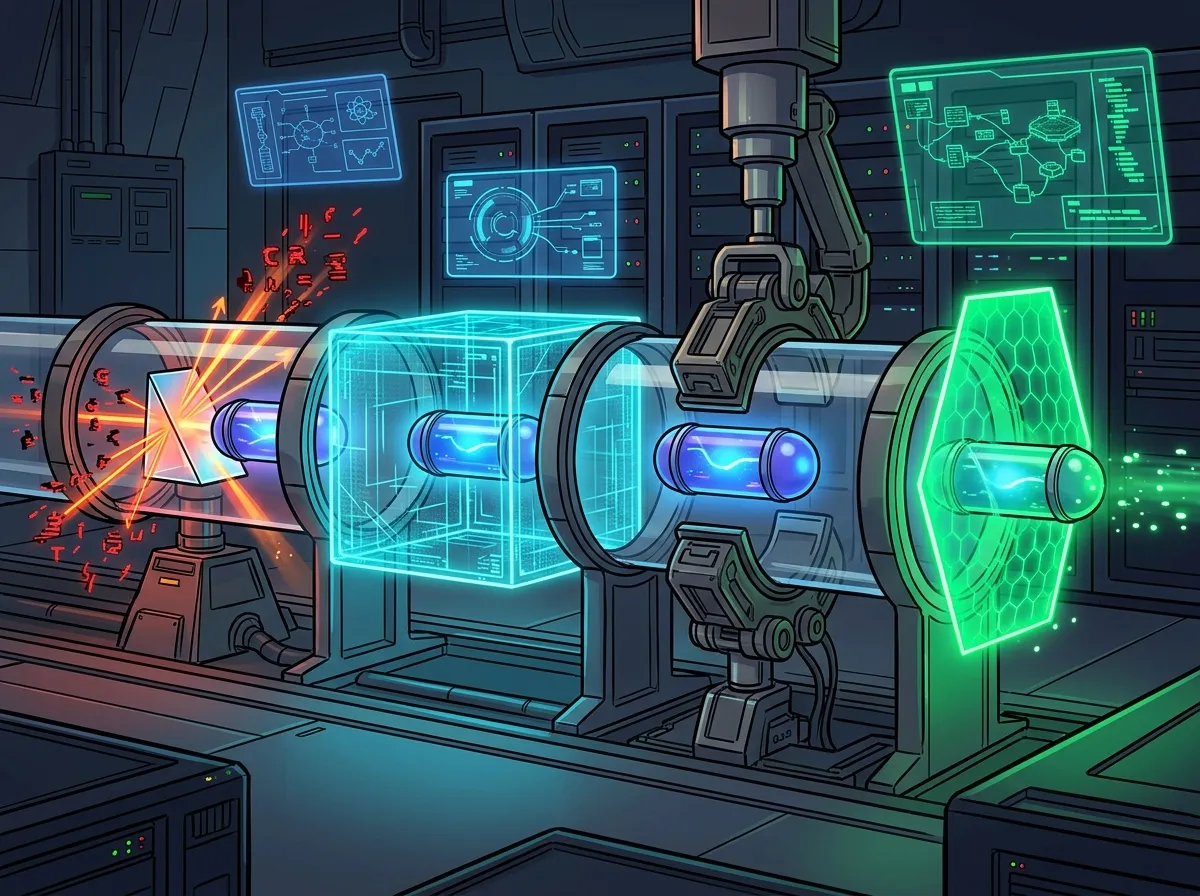
Vorab-Filterung eliminiert verdächtige Steuerzeichen und unsichtbare Unicodes.
Kapselung des Inputs in strikt isolierende XML-Container als ungesicherte Daten.
Verankerung aller Sicherheitsregeln unmittelbar vor der Generierung.
Ein sekundärer Check überprüft den finalen Output auf Datenlecks und Richtlinien.
Automatisierung, Evals & DSPy: Der Wandel zur programmatischen Optimierung
Schluss mit Bauchgefühl: Kuratierte Test-Datensätze und Regressionstests im CI/CD-Zyklus
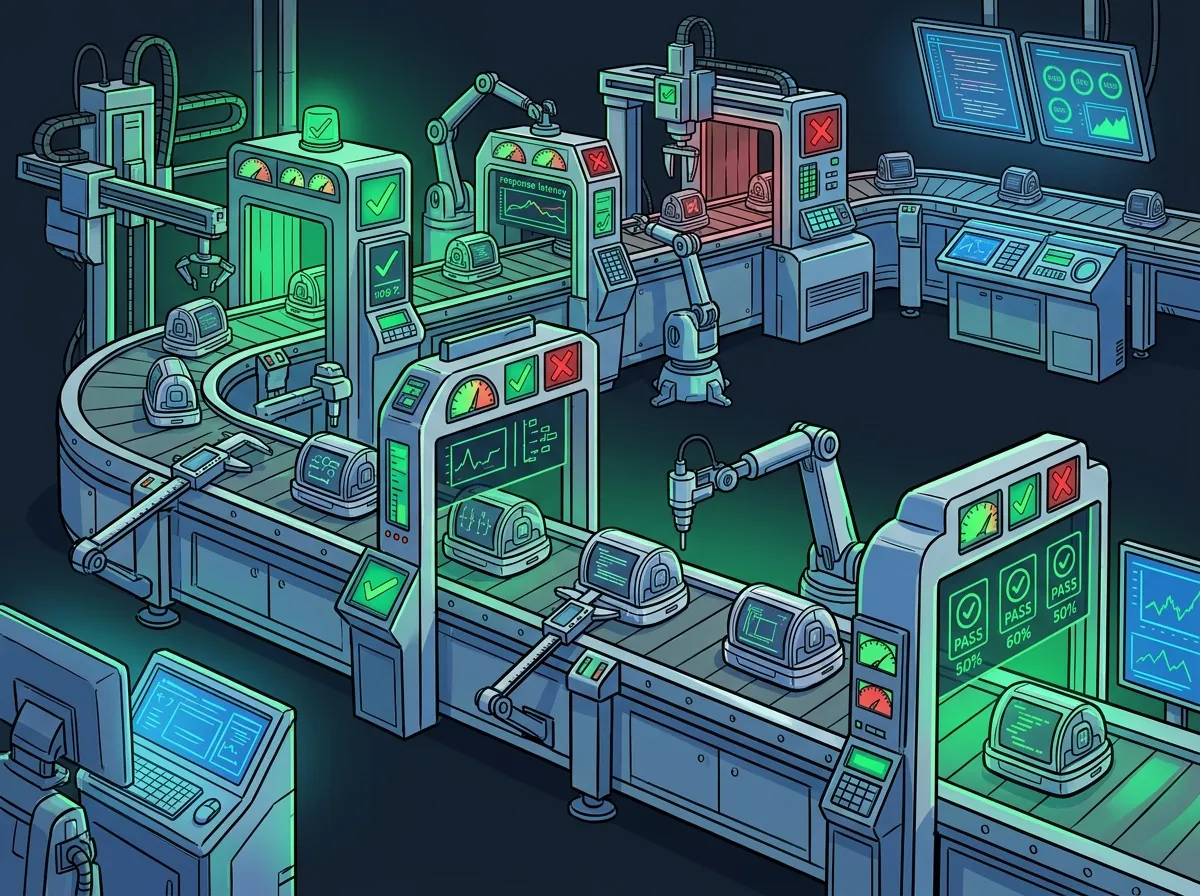
Prompts werden wie Code anhand von fünfzig bis zweihundert Referenzfällen gemessen, um ungewollte Regressionen sofort zu stoppen.
Automatisierte Code-Prüfung auf JSON-Validität, Feld-Vollständigkeit und Regex-Muster.
Ein starkes Schiedsrichter-Modell bewertet Semantik, Relevanz und Markentonfall nach festen Rubriken.
Khattab et al. 2023: Warum wir Prompts in Zukunft kompilieren statt manuell zu tippen
„Wir haben wochenlang gefeilt – mit dem nächsten Modell-Update funktionierte nichts mehr.“
Jedes neue Modell-Checkpoint erfordert Anpassungen: Mühsam ertestete Formulierungen brechen oft zusammen und erzwingen manuelles Re-Engineering.
Ingenieure verbringen wertvolle Entwicklungszeit mit endlosem sprachlichem Feinschliff statt Systemarchitektur und robuster Pipeline-Logik.
Prompts werden automatisch gegen eine Verlustfunktion kompiliert und optimiert.
Definition rein über I/O (z. B. `context, query -> answer`), völlig losgelöst von konkreten Prompt-Strings.
Der Compiler wählt selbstständig die besten Demonstrationen für maximale Zielmetriken auf Ihren Daten.
Vier Kernmuster für komplexe Workflows: Vom Monolithen zu modularen Multi-Prompt-Systemen
Ein schlanker Router leitet Anfragen über eine Klassifikations-Weiche an spezialisierte Prompts weiter.
Aufgaben werden in Stufen zerlegt: Jeder Schritt wird vor der Weitergabe deterministisch validiert.
Große Datenmengen werden in simultan verarbeitete Teilabschnitte aufgeteilt und synthetisiert.
Ein Modell generiert, während ein Critic-Modell den Entwurf iteriert, bis Qualitätskriterien erfüllt sind.
Der verbindliche Leitfaden: Von Ad-hoc-Versuchen zu reproduzierbarer Exzellenz
Versionierung in Git, Review-Prozesse und jeden Prompt wie produktiven Quellcode behandeln.
Kein Freitext für Backends: Immer strikte strukturierte Schemas statt Freitext nutzen.
Kein blindes Vertrauen: Fakten immer explizit im Kontext mit Dokumenten absichern.
Determinismus sichern durch explizite 'Ich weiß es nicht'-Abbruchklauseln.
Keine Monster-Prompts: komplexe Vorhaben in modulare Ketten statt Monster-Prompts zerlegen.
Vom Experiment zur unternehmensweiten Skalierung: Die Zukunft gehört getesteten, typisierten Pipelines
Vom Experiment zum System: die neue Ingenieursdisziplin an stochastischen Schnittstellen.
Nicht wer kreativ tippt gewinnt, sondern wer einen uneinholbaren Vorsprung an Verlässlichkeit aufbaut und systematisch testet.
Kontinuierliche Evolution: Die Reise führt von manuellen Prompts zu versionierten, automatisiert geprüften Agenten-Pipelines im Betrieb.
Verifizierte Prompts und Schemas sichern reproduzierbare Pipelines im Produktivbetrieb.
Forschungsberichte, interaktive Folien und Code-Beispiele sind auf hackenberg.tech für weiterführende Materialien frei abrufbar.
Dr. Georg Hackenberg · FH Oberösterreich · Professor für Informatik & Industriesysteme Campus Wels – Austausch und Kooperation.
Academic citations & source materials