•68 slides · ~45 min
SEO im Zeitalter von KI: Strategien für SEO, GEO, AIO und AEO
Von Suchmaschinen zu generativen Antwortsystemen – Paradigmenwechsel für Industrie und B2B-Mittelstand
Von Suchmaschinen zu generativen Antwortsystemen – Paradigmenwechsel für Industrie und B2B-Mittelstand
Strategien für SEO, GEO, AEO & AIO – Von Suchmaschinen zu generativen Antwortsystemen
Gliederung des 60-Minuten-Vortrags in 6 didaktische Blöcke
Vom statischen Web-Index zur generativen Antwortsynthese moderner Sprachmodelle.
RAG, Embeddings, Wissensgraphen und empirische Studienmethodik und Limitationen.
Schema.org-Modellierung, E-E-A-T und Information Gain Content Design im B2B.
Google Antigravity, AGENTS.md, MCP Server und automatisierte CI/CD Gatekeeper.
Edelman-LinkedIn Thought Leadership, sameAs-Entitätsgraphen und Hub-and-Spoke.
Similarweb, Gartner, Opollo Benchmarks und der 90-Tage-Fahrplan zur KI-Sichtbarkeit.
Der fundamentale Bruch mit 25 Jahren Suchmaschinengeschichte
https://example.com/pumpen – Entdecken Sie unsere energieeffizienten Pumpensysteme und Aggregate für die chemische Industrie…
Abgleich exakter Zeichenketten im Web-Index.
Seitenbesuch nötig, um die Antwort zu finden.
Webseiten lebten von reinen Klickzahlen.
Für chemische B2B-Anlagen eignen sich Magnetkupplungspumpen nach ISO 2858 mit Wirkungsgraden über 82 % und integrierter Sensorik.
Sprachmodelle erfassen präzise den Kontext hinter der Nutzerfrage und die Suchabsicht.
Zero-Click : Infos werden sofort serviert.
Erfolg durch Nennung und Entitäts-Verankerung.
Wenn Suchmaschinen den Klick auf Ihre Website überflüssig machen
SparkToro & Datos 2024 : Nur 374 von 1.000 Suchen führen ins freie Web
„Wir optimieren nicht mehr für Klicks – wir optimieren für Zitation und unumstößliche Markennennung.“
Gartner prognostiziert einen Verlust von 25 Prozent des Suchvolumens bis 2026 durch KI-Chatbots.
Kunden, die nach einer synthetisierten KI-Antwort noch klicken, haben höchste Kauf- und Projektabsicht (High-Intent B2B).
Wie Google 25 Jahre funktionierte: Vom Web-Crawler über Inverted Index zu RankBrain
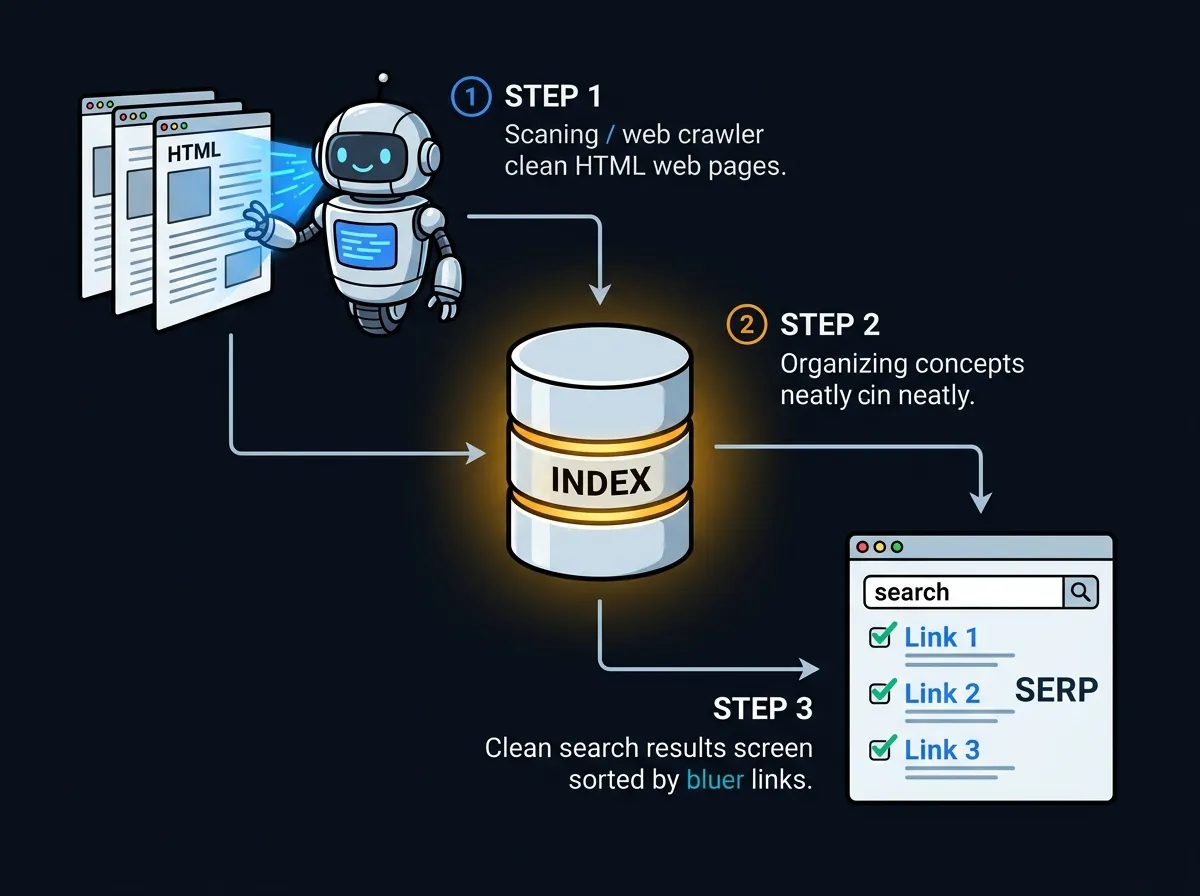
Grundstein der klassischen Suchmaschine : Vom Web-Graph zur SERP.
Automatisierte Web-Crawler erfassen HTML über Hyperlink-Graphen ins Rohdaten-Archiv.
Extrahierte Terme werden in riesigen invertierten Index-Matrizen katalogisiert.
Linkautorität und Machine Learning berechnen die statische Rangfolge der zehn blauen Links.
Vier Optimierungsdisziplinen, ihre Zielsysteme und Erfolgsmetriken im Vergleich
Vom statischen Web-Index zur generativen Antwortsynthese
Retrieval-Augmented Generation als Brücke zwischen Modell und aktuellem Web
Nutzerfrage wird in semantische Absicht (Intent) und gesuchte Entitäten zerlegt.
Vektorsuche ruft nach dem RAG-Prinzip die Top-Text-Chunks aus dem aktuellen Index ab. Nur hochrelevante Absätze kommen weiter.
Die gefundenen Chunks werden zusammen mit System-Instruktionen in das Context Window des LLMs injiziert.
Das Modell erzeugt die finale Antwort mit Zitations-Chips basierend auf den injizierten Daten.
Warum RAG Pflicht ist: Dramatischer Aufmerksamkeitsabfall in langen LLM-Kontexten
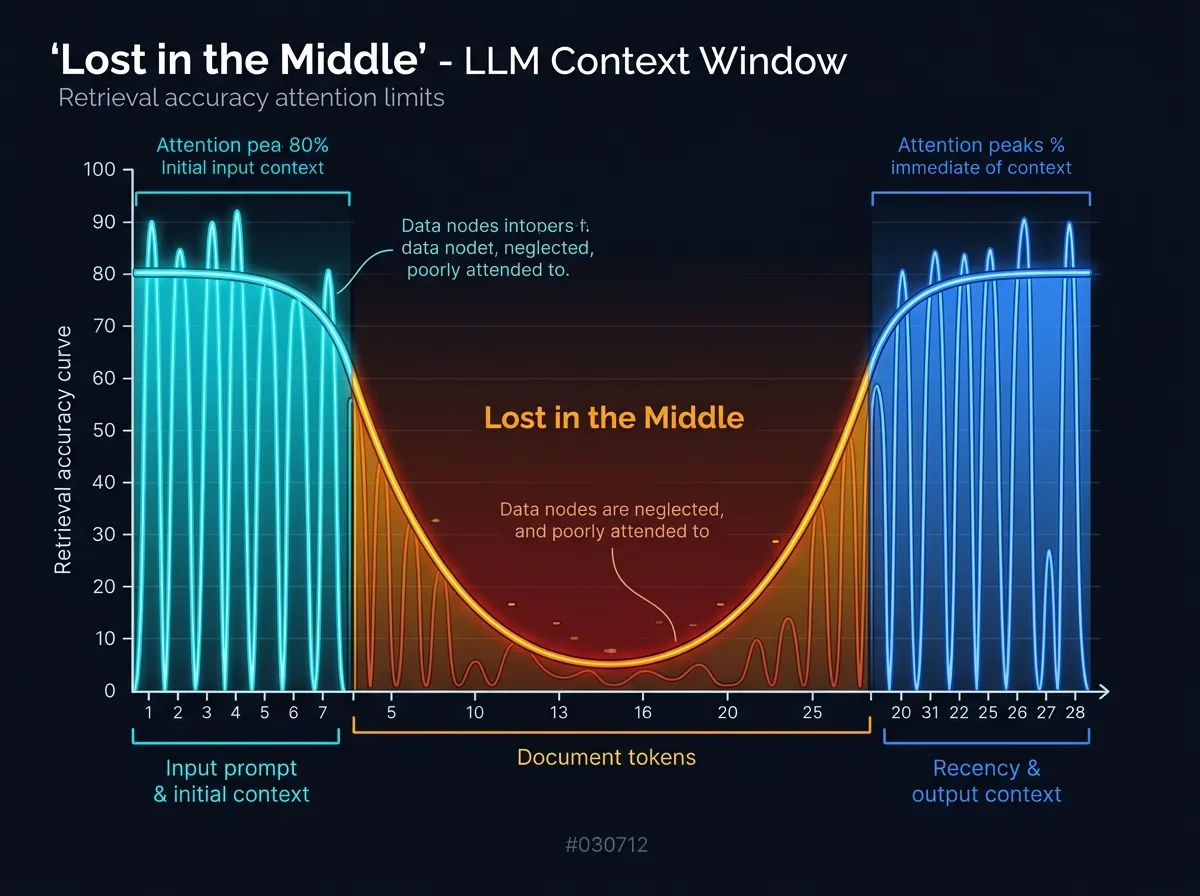
TACL-Studie : Mittig platzierte Dokumente werden von LLMs systematisch übersehen.
Informationen zu Beginn werden mit bis zu neunzig Prozent Genauigkeit extrahiert.
Am Dokumentenende können Fakten durch den Recency-Effekt haften bleiben.
Im mittleren Token-Bereich stürzt die Abrufpräzision auf unter dreißig Prozent ab.
Von Zeichenketten zu Bedeutungen im hochdimensionalen Vektorraum
// Passage A: “Industrielle Wärmepumpe” [0.0214, -0.0531, 0.0892, 0.0117, -0.0438, …] // Passage B: “Energieeffiziente Prozesswärme B2B” [0.0209, -0.0518, 0.0874, 0.0125, -0.0421, …]
Synonyme und verwandte Konzepte besitzen im Vektorraum nahezu identische Vektor-Winkel.
Künstliche Keyword-Wiederholungen verzerren den Vektor und senken die semantische Relevanz.
Wertebereich: Von -1.0 (semantisches Gegenteil) über 0.0 (orthogonal und thematisch unabhängig) bis +1.0 (identische inhaltliche Bedeutung im hochdimensionalen Vektorraum unabhängig von der Wortwahl).
RAG-Systeme berechnen die Distanz aller Dokument-Chunks zur Suchanfrage in Millisekunden und injizieren die Top-K Passagen mit den höchsten Kosinus-Werten als fundierte Faktenbasis direkt in das Context Window des Sprachmodells.
Bedeutungsnähe ohne Keyword-Match: Geometrische Distanz im multidimensionalen Latent Space
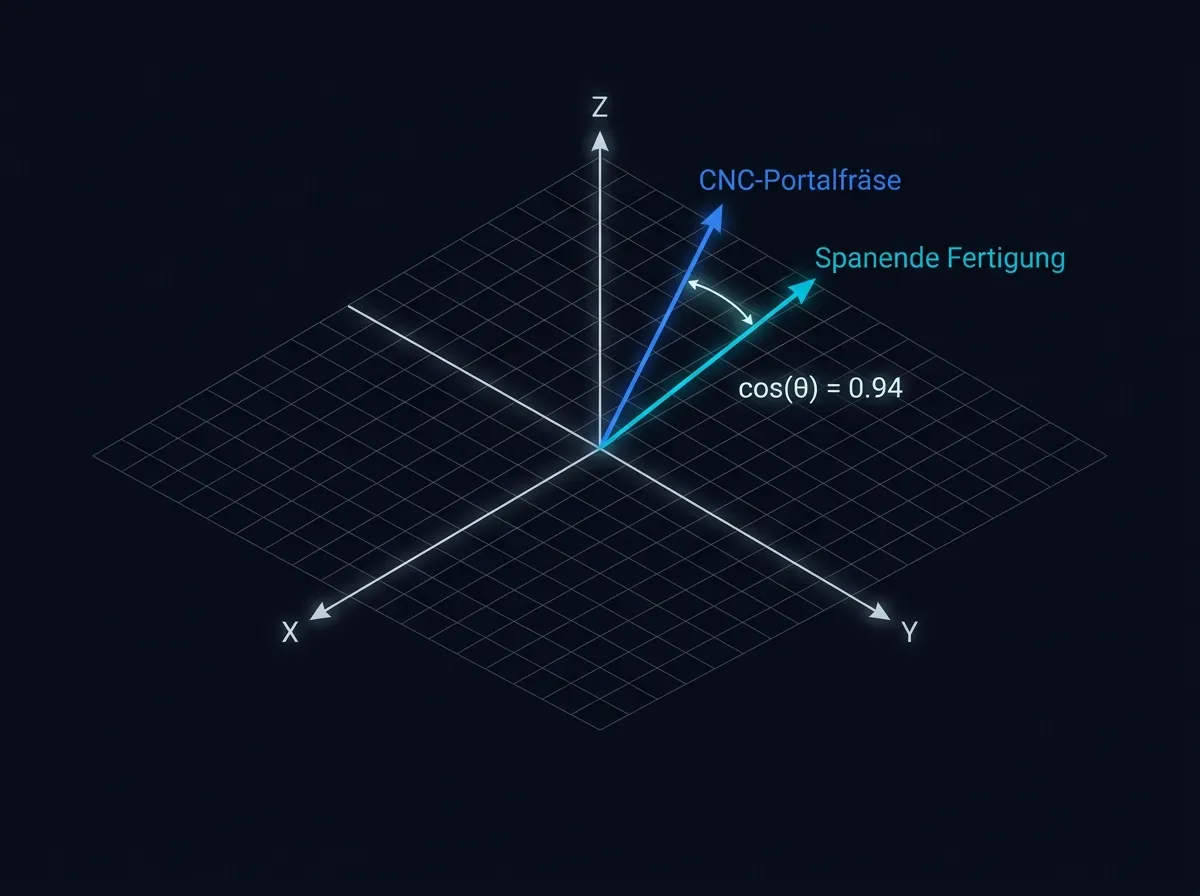
Sentence-BERT-Modellierung : Skalarprodukt normierter Einheitsvektoren.
Texte werden in hochdimensionale Zahlenvektoren übersetzt.
B2B-Fachbegriffe weisen minimale Winkelabstände ohne Wortübereinstimmung auf.
RAG-Systeme selektieren die semantisch treffendsten Textpassagen blitzschnell.
Semantische Ähnlichkeit reicht nicht: Fragmentierte Chunks und fehlende Kausalitätslogik
Dokumente werden zerschnitten; Vektornähe unterscheidet weder Prädikate noch Verneinungen.
Kooperation und gerichtliche Klage liegen im Vektorraum nah beieinander.
Beim 500-Token-Chunking gehen wichtige Provenienz- und Kontextstrukturen verloren.
Marcus : Statistische Wahrscheinlichkeiten garantieren keine Logik.
[Anfrage] → [Zulieferer X] —(liefert)—> [Komponente Y] —(Norm)—> [IEC 62109]
Erfordert eine relationale Schlussfolgerungskette über mehrere Dokumente.
Vektorsuche kann relationale Kanten nicht prüfen und rät ins Blaue hinein.
Pan et al. : Symbolische Wissensgraphen als verlässliches Fundament.
Warum unstrukturierte Vektoren versagen und Relationen im Wissensgraphen entscheiden
Eindeutige Knoten und Relationen statt unstrukturierter Volltext-Schnipsel (Things, not strings )
Relationen sind im Graphen eindeutig verankert. Das Modell muss Zusammenhänge nicht erraten.
Verhindert Verwechslungen gleichnamiger Marken durch persistente Bezeichner.
Ermöglicht komplexe Schlussfolgerungen über Beziehungsebenen hinweg.
Die Rolle freier Wissensgraphen: Von Community-Daten zum Ground-Truth-Anker für Sprachmodelle
Wissenschaftliche Grundlegung des kollaborativen Wissensgraphen .
Über 110 Millionen weltweit eindeutige Entitäten-IDs (Q-IDs) und semantische Properties (P-IDs).
Fakten werden als sprachunabhängige semantische Tripel gespeichert und global synchronisiert.
Ermöglicht hochkomplexe semantische Graph-Abfragen über das gesamte vernetzte Weltwissen.
Wie ChatGPT, Gemini und Claude Fakten verifizieren und verankern.
Kuratiertes Trainingsfundament zur Vermeidung faktischer Halluzinationen bei Sprachmodellen.
Verhindert Verwechslungen gleichnamiger B2B-Unternehmen und Fachtermini.
Schema.org-Verknüpfung via sameAs auf die eigene Wikidata-Q-ID sichert unmissverständliche KI-Präsenz.
Faktenverankerung in KI-Modellen: Wie Wissensgraphen und Primärquellen generative Drift stoppen
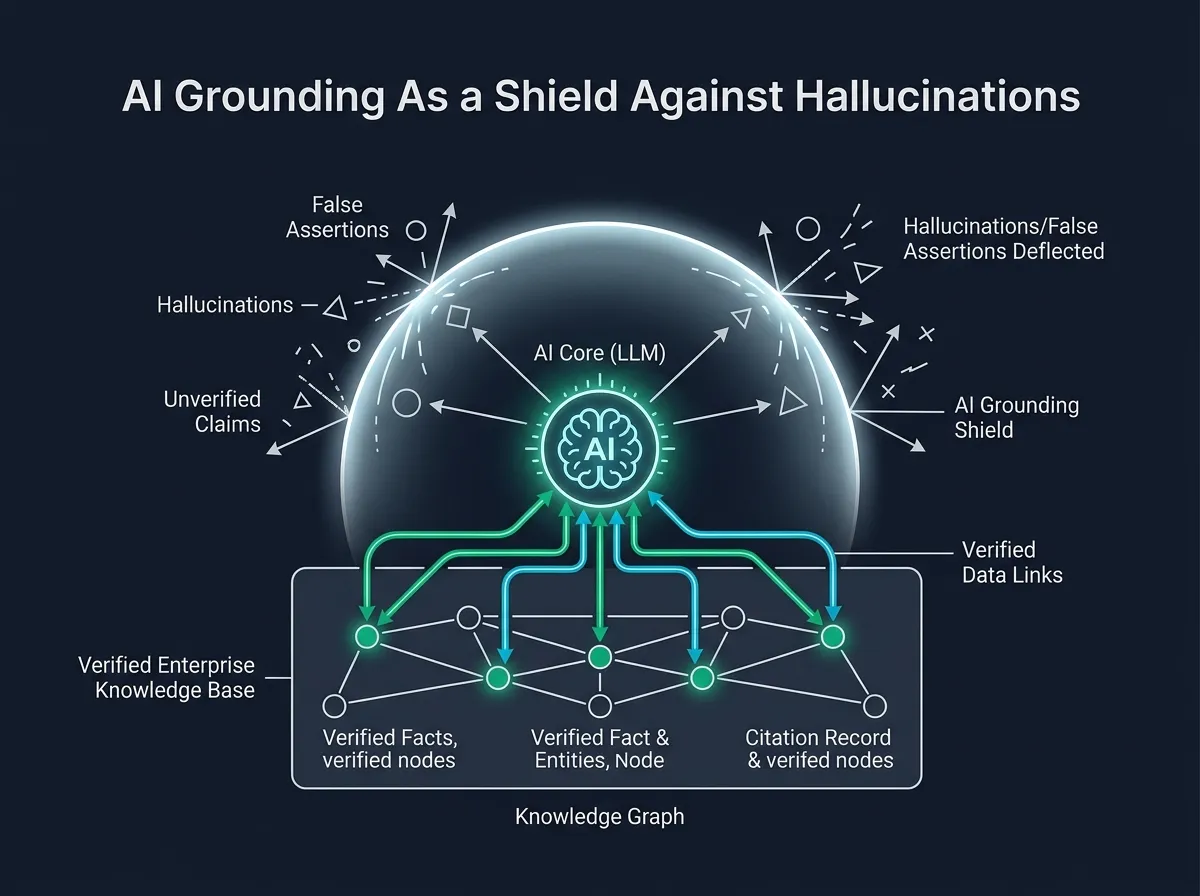
NeurIPS-Grundlagenforschung : Grounding bindet generative Wahrscheinlichkeiten an überprüfbare Faktenknoten.
Über semantische Kanten liefern strukturierte Wissensgraphen deterministische Relationen.
Verifizierte Quellen ermöglichen es, dass Inline-Zitate jede Aussage nachprüfbar belegen.
Faktentreue Filter stellen sicher, dass halluzinierte Falschbehauptungen vor der Ausgabe abgefangen werden.
Das Beste beider Welten: Wie Sprachgefühl und Faktenlogik in Antwortsystemen verschmelzen
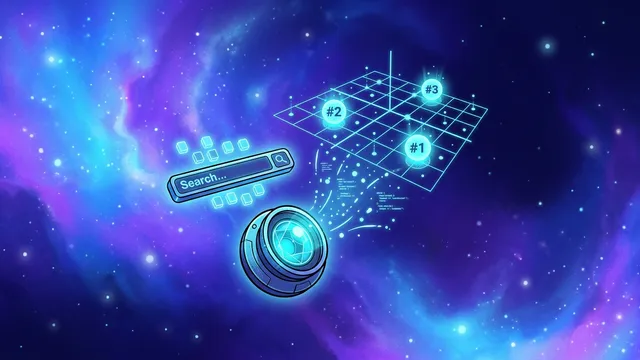
Embedding der Suchanfrage: Synonyme und Suchabsichten flexibel erfassen und Textkandidaten filtern.
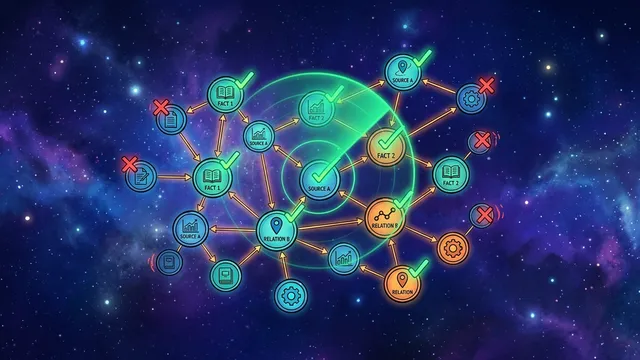
Deterministische Validierung im Graphen: Entitäten und Kanten im Wissensgraphen validieren und Halluzinationen filtern.
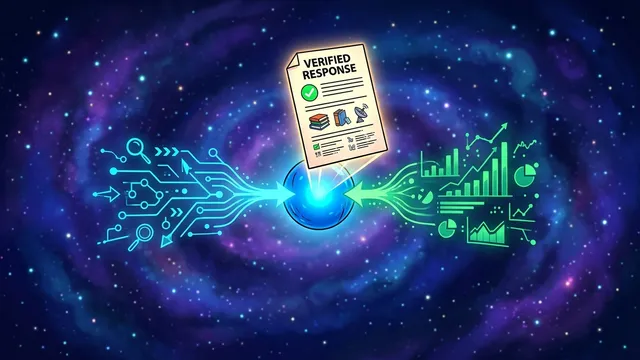
GraphRAG-Fusion : Geprüfte Faktenknoten und Primärquellen verschmelzen zur fehlerfreien B2B-Antwort.
Microsoft Research: Wie Community Detection und Leiden-Clustering Vektoren schlagen
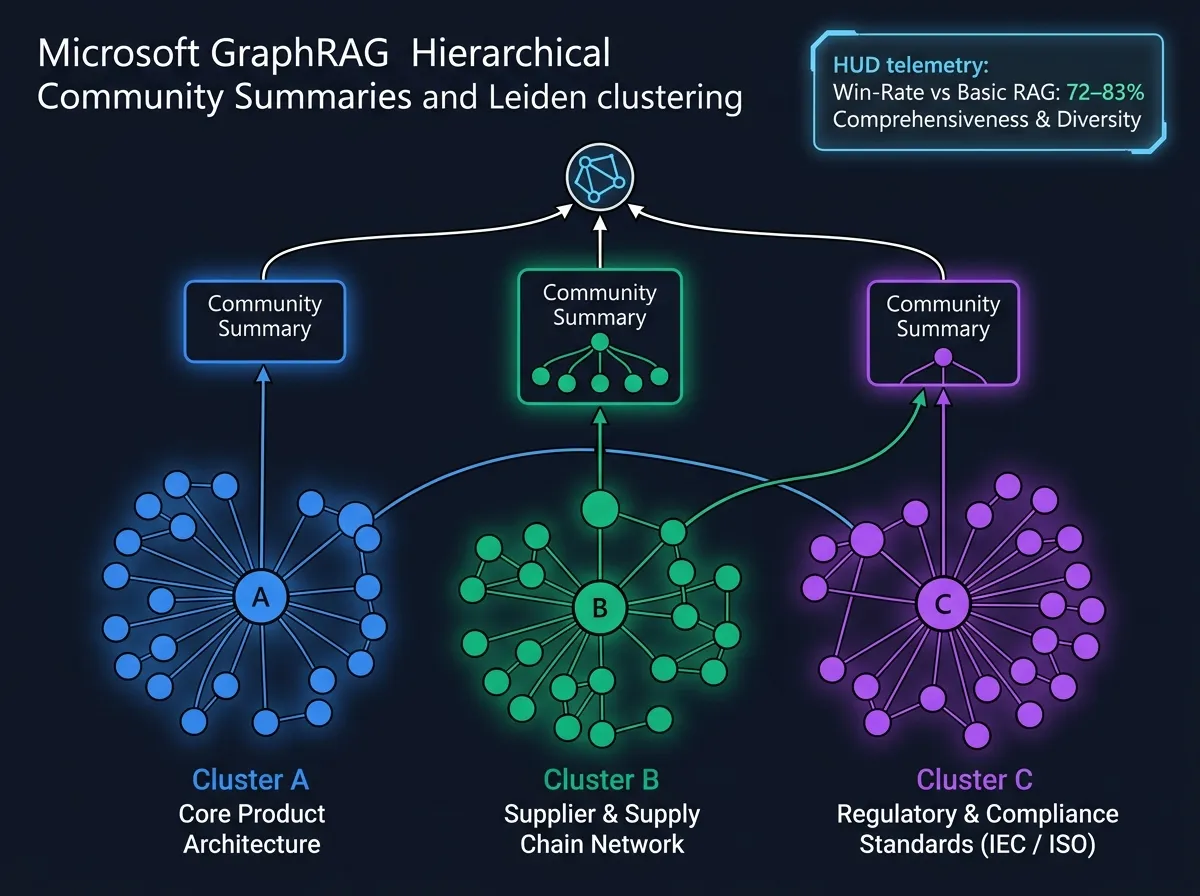
Microsoft Research : Vektoren finden Detailfakten, scheitern aber an globalen Leitfragen.
Wissensgraphen werden durch Algorithmen durch den Leiden-Algorithmus hierarchisch in dichte Wissensgemeinschaften zerlegt.
Auf jeder Cluster-Ebene generiert ein LLM vorab eine vollständige semantische Zusammenfassung.
Bei übergreifenden B2B-Anfragen liest das System nur diese Community Summaries statt zehntausender Text-Chunks.
Benchmarks (Edge et al. 2024): Klare Überlegenheit bei Vollständigkeit und Perspektivenvielfalt
Edge et al. , Microsoft Research
Mit 83 % Win-Rate deckt GraphRAG alle relevanten Aspekte lückenlos ab.
Mit 82 % Win-Rate bricht Perspektivenvielfalt den Vektor-Tunnelblick.
Im Blindtest werden Antworten von Fachprüfern als fundierter bewertet.
Fokus auf Normen & Systemarchitektur.
Im B2B-Einkauf liefert die KI komplette Systemübersichten ohne Lücken.
Damit können komplexe Ausschreibungen und Lieferketten gelöst werden.
Dieser Qualitätsgewinn erfordert jedoch hohe Rechen- und Tokenbudgets!
Methodische Grenzen: Warum mehr Kontext Rechenkosten und Latenz explodieren lässt
Graph-Extraktion erfordert umfangreiche Vorab-LLM-Aufrufe zur Entitätserkennung.
Laut Edge et al. entsteht ein vielfach höherer Rechenaufwand als bei reinen Vektor-Embeddings.
Hierarchische Community-Traversierung erzeugt spürbare Antwortverzögerungen im Vergleich zu Vektor-Top-K.
Entfaltet Stärken nur bei dichter, semantisch vernetzter Fachdokumentation.
Punktuelle Abfragen nach Spezifikationen sind mit Standard-Vektorsuche schneller und präziser.
Klassisches RAG beantwortet isolierte Faktenfragen ohne Overhead.
Senkt die Rechenkosten pro Suchanfrage um bis zu neunzig Prozent gegenüber Graphen.
Direkte Textpassagen schützen vor Halluzinationen durch Modell-Zwischenschritte.
KI-Sucharchitekturen im Vergleich: Wie Google, Perplexity, ChatGPT und Claude Quellen wählen
Hybrid-Index & Zitations-Chips
Google kombiniert klassischen RankBrain-SERP-Index mit LLM-Synthese . Hohe Gewichtung von PageSpeed, Core Web Vitals und verifizierten E-E-A-T-Signalen in prominenten Zitations-Chips.
Multimodales Web-Grounding
Direkter Zugriff auf den Web-Index über Google Search: Echtzeit-Grounding mit multimodaler Verarbeitung von Texten, Tabellen und PDF-Datenblättern ohne statische Token-Grenzen.
Transparente Quellen-Engine
Live-Websuche mit maximaler Zitationsdichte: Bevorzugt primäre Fachdokumentationen, Foren und Datenblätter. Listet Belege als interaktive Fußnoten mit direkter Link-Verknüpfung.
Konversationelle Synthese
ChatGPT nutzt Bing-Index und Publisher-Feeds für kontextuelle Empfehlungen im Dialog, während Claude auf tiefgehende Dokumentenanalysen und Code-Verständnis spezialisiert ist.
Wissenschaftlicher Nachweis: Wie sich die Zitationswahrscheinlichkeit in Sprachmodellen steigern lässt
Studie : ACM SIGKDD 2024 (Princeton, Georgia Tech, Allen AI) über 10.000 Queries
Methodischer Befund (GEO-Bench): Über 10.000 reale Suchanfragen hinweg bevorzugen generative Sprachmodelle nachweisbar Inhalte mit hoher Faktendichte, konkreten Messwerten und verifizierbaren Primärquellen, während klassische SEO-Manipulationen wie Keyword-Wiederholungen durch die Relevanzfilter moderner RAG-Systeme systematisch abgestraft werden.
Kritische Würdigung der GEO-bench: Versuchsaufbau, Metriken und Gültigkeitsgrenzen
Aggarwal et al. evaluierten neun Datensätze mit der exponentiell gewichteten Zitationsmetrik Imp_pwc.
Kombination aus Google Top-5 Retrieval mit GPT-3.5 Synthese.
Zusätzliche Tests auf Perplexity.ai bestätigen Zitationsgewinne im realen Web.
Websites auf Position 5 steigern ihre Sichtbarkeit durch Belege um 115 Prozent.
GEO optimiert On-Page-Inhalte – Seiten müssen bereits in den Top-Suchergebnissen gecrawlt werden.
Untersuchung basierte auf statischen Momentaufnahmen ohne Live-Ranking-Änderung.
Flächendeckende GEO-Optimierung führt zu Sättigung und abnehmendem Grenznutzen.
Unterschiedliche Prompt-Formulierungen verändern die relative Stärke einzelner Heuristiken.
Vom theoretischen Verständnis zur maschinenlesbaren Autorität
Das ganzheitliche Framework für nachhaltige Sichtbarkeit in KI-Modellen
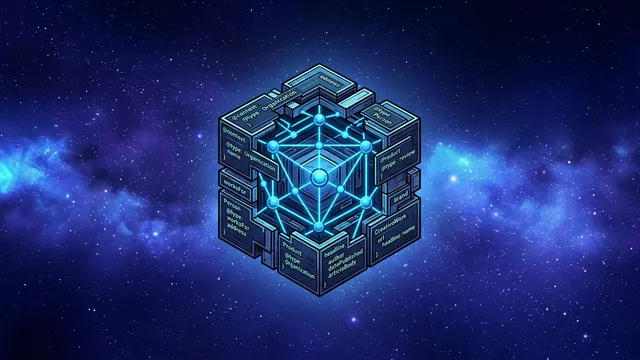
Schema.org @graph Architektur, JSON-LD, standardisiertes semantisches HTML5 und eindeutige Entitäten-URIs.
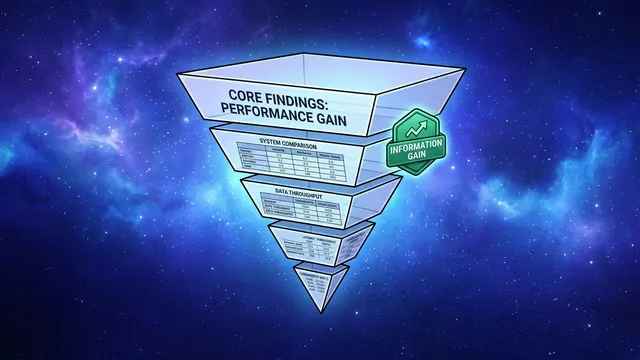
Information Gain Scores maximieren, BLUF-Informationsarchitektur, dichte Vergleichstabellen und proprietäre Messdaten.
E-E-A-T-Signale, Co-Citations, Autorenvalidierung via ORCID / Wikidata und institutionelle akademische Verankerung.
Die verbindliche Lingua Franca zwischen Unternehmenswebsite und KI-Webcrawlern
Rechtlicher Name, Logo, sameAs zu Wikidata und LinkedIn, Standorte.
Geschäftsführung und Lead-Ingenieure mit ORCID und Patenten.
Industrieprodukte mit GTIN, MPN und ISO-Zertifikaten.
Direkte Frage-Antwort-Paare mit autoritativem Verfasser .
Eindeutige URIs verknüpfen Entitäten global: https://firma.at/#organization, https://firma.at/team/dr-mueller/#author und https://firma.at/produkte/serie-x/#product.
Entitäten werden einmal deklariert und via URI referenziert.
Sprachmodelle fusionieren alle Aussagen unter derselben ID.
Disambiguierung von Marke und Urheber über eindeutige URI-Identifier im @graph
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://hackenberg.tech/#organization",
      "name": "Dr. Georg Hackenberg Consulting",
      "url": "https://hackenberg.tech",
      "sameAs": [
        "https://www.linkedin.com/in/georghackenberg/",
        "https://orcid.org/0000-0003-3913-4148"
      ]
    },
    {
      "@type": "Person",
      "@id": "https://hackenberg.tech/#georg",
      "name": "Dr. Georg Hackenberg",
      "jobTitle": "Professor für Informatik",
      "worksFor": {
        "@id": "https://www.fh-ooe.at/#organization"
      },
      "sameAs": "https://orcid.org/0000-0003-3913-4148"
    }
  ]
}Disambiguierung von Marke und Urheber über globale Linked-Data-Register als maschinenlesbarer Schutz vor Modell-Halluzinationen.
Vergibt für Marke und Person eindeutige, webweit referenzierbare Identifier zur zweifelsfreien Knotenverknüpfung im Knowledge Graph.
Verbindet lokale Entitäten direkt mit ORCID, Wikidata und LinkedIn-Profilen als extern verifizierbare Vertrauensanker.
Verknüpft Personen über worksFor unmissverständlich mit der Primärorganisation und sichert den fachlichen Autoritätsnachweis.
Dieses maschinenlesbare Entitätsnetz bildet das Rückgrat für verlässliches Grounding in generativen Suchsystemen.
Verknüpfung von Fachartikeln, Urhebern und Themen ohne Datenredundanz für KI-Crawler
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "TechArticle",
      "@id": "https://hackenberg.tech/posts/geo/#article",
      "headline": "Generative Engine Optimization",
      "inLanguage": "de-AT",
      "author": {
        "@id": "https://hackenberg.tech/#georg"
      },
      "publisher": {
        "@id": "https://hackenberg.tech/#organization"
      },
      "about": [
        { "@type": "Thing", "name": "Künstliche Intelligenz" }
      ]
    }
  ]
}Statt Metadaten zu kopieren, verlinkt der Artikel per URI-Pointer auf bestehende Knoten.
Autor und Publisher werden über `@id`-Referenzen ohne Datenredundanz angebunden .
GPTBot und Perplexity extrahieren Urheberschaft und Provenienz als harte Fakten.
Das `about`-Feld bindet Inhalte strukturiert in den globalen Themenkontext ein.
Warum Sprachmodelle anonyme Artikel abwerten und verifizierte Experten bevorzugen
Google E-E-A-T definiert zentrale Vertrauenssignale – in Sprachmodellen führt die explizite Ausweisung verifizierter Fachautoren zu klarer Bevorzugung gegenüber generischem KI-Spam bei der Quellenwahl.
Eigene Profilseite für jeden Fachautor (z. B. `/team/dr-schmidt/`).
Direkte Links auf ORCID, Scholar und LinkedIn sowie externe Register und offizielle Fachgremien im JSON-LD.
Echte Autorenprofile schaffen den entscheidenden Vertrauensanker im B2B: Nachweisbare Industrieprojekte und Normengremien sichern langfristig die Zitierfähigkeit und hohe Entitäts-Autorität in generativen Sprachmodellen.
Reale Felddaten: Warum KI-Modelle Primärdaten gegenüber synthetischer Theorie bevorzugen
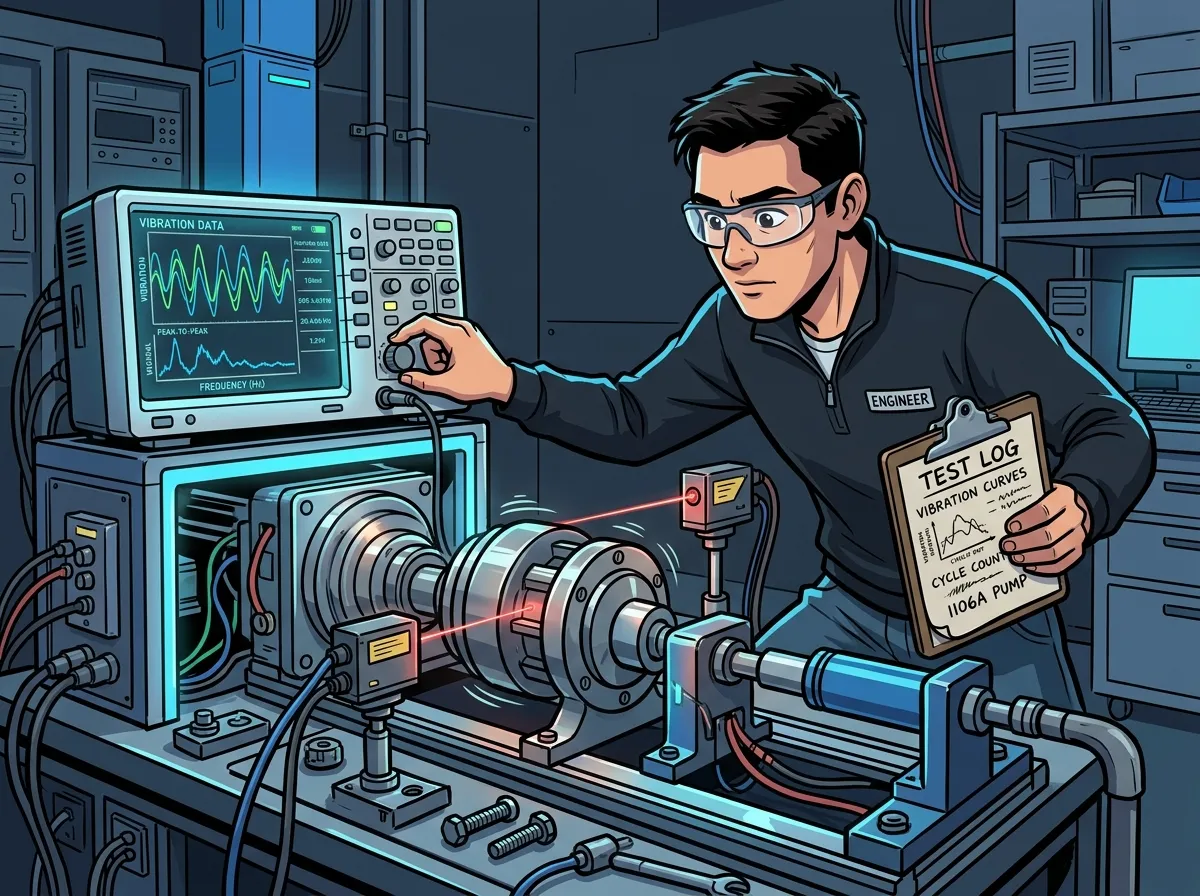
Google Helpful Content Richtlinien : Reale First-Hand Experience filtert synthetischen KI-Spam zuverlässig aus.
Veröffentlichung von unverfälschten Messreihen und Ausfallwahrscheinlichkeiten aus realen Belastungsproben.
Dokumentation von realen Baugruppen und Werkzeugen aus der Werkstatt statt austauschbarer Stock-Grafiken.
Nachweisbarer Erkenntnisgewinn durch konkrete Fehleranalysen und Grenzwert-Erfahrungen aus dem Industriealltag.
Mathematische Tiefe: Wie namentliche Experten, Patente und Berechnungen Zitationen sichern
Google Qualitätsstandards : Nachweisbare Qualifikation und formale Modellierung erzeugen maximale Zitationswahrscheinlichkeit.
Detaillierte Autorenprofile mit akademischem Hintergrund und Fachschwerpunkten.
Transparente Dokumentation von patentierten Verfahren und Berechnungsmodellen.
Veröffentlichung von belastbaren Auslegungsformeln für Traglasten und thermische Belastungen.
Peer-Anerkennung: Wie Gremienarbeit, Keynotes und Fachzitate die Marken-Autorität stärken
Google Quality Rater Guidelines : Autorität wird von Suchmaschinen über Co-Zitationen und externe Fachgremien validiert.
Dokumentation von Keynote-Vorträgen auf Industrie- und Hochschulkongressen.
Nachweisbarer Einsatz durch aktive Gremienarbeit in VDI- und Normungsausschüssen.
Erwähnungen durch unabhängige Fachmedien-Zitate und universitäre Forschungskooperationen.
Datenintegrität: Das E-E-A-T-Fundament durch ISO-Audits, Prüfzeugnisse und offene Grenzwerte
Google Quality Framework : Trust ist der zentrale Dreh- und Angelpunkt – ohne verifizierte Integrität greifen Abwertungsfilter.
Direkte Bereitstellung von offiziellen ISO-Zertifikaten und akkreditierten Prüfberichten.
Publikation von exakten Toleranzgrenzen und Werkstoffspezifikationen ohne Werbefloskeln.
Dokumentation von offenen Messmethoden mit transparentem Revisionsverlauf.
Google Patent US 11,720,613 B2 & BLUF: Warum Primärdaten nach vorne gehören
„In der heutigen modernen Welt wird Energieeffizienz für Unternehmen immer wichtiger. Viele fragen sich daher, was eine Industriepumpe ist… In diesem Beitrag beleuchten wir ausführlich…“
Liefert keine neue Information für das Retrieval-Modell.
Wichtigste Daten werden erst am Seitenende versteckt.
Chunker extrahiert wertlose Füllsätze ins Kontextfenster.
Direktantwort (45 Wörter): Magnetkupplungspumpen der Serie X erreichen bei 2.900 U/min einen Wirkungsgrad von 84,2 % und sparen gegenüber herkömmlichen Stopfbuchspumpen bis zu 14,8 kWh pro Betriebstag ein. Sie sind nach ATEX Zone 1 zertifiziert.
Dient als idealer Zitationsblock für Perplexity und Gemini direkt am Dokumentanfang für die automatisierte Extraktion in RAG-Systemen.
Sichert hohen Information Gain durch exklusive Primärdaten .
Bottom Line Up Front: Die umgekehrte Pyramide für perfekte maschinenlesbare Extraktion
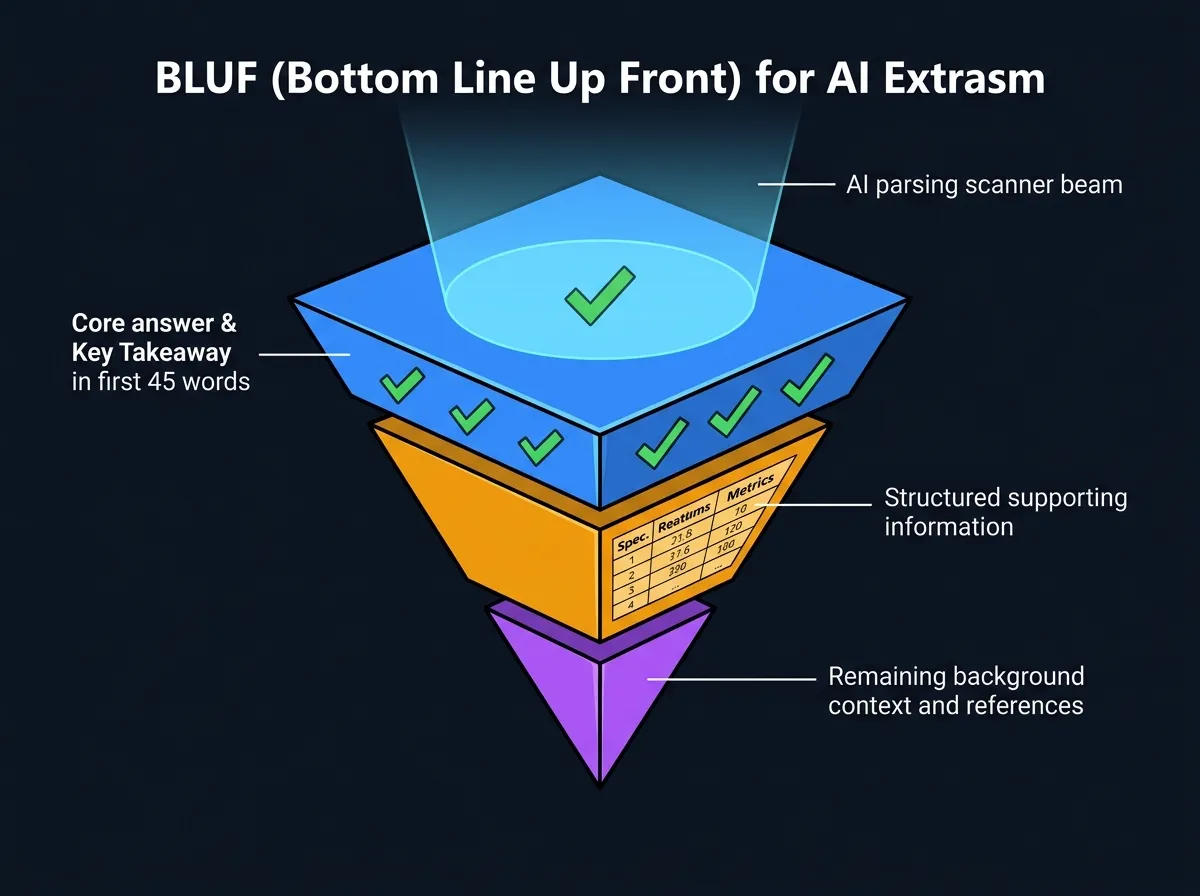
Information Gain Optimierung : Schnelle semantische Treffer im ersten Chunk.
Die gesuchte Spezifikation liefert der erste Satz als präzise Kernantwort.
Wichtige Kennzahlen folgen in einer strukturierten Markdown-Tabelle.
Erst danach liefern Hintergründe und Methodik das Fundament für LLM-Begründungen.
Fluff vs. Information Gain: Wie strukturierte Antworten RAG-Chunker und Zitate sichern
„In der heutigen dynamischen Welt des Maschinenbaus stehen Konstrukteure vor großen Herausforderungen. Als führender Partner entwickeln wir maßgeschneiderte, zukunftssichere Antriebslösungen…“
Ausschließlich austauschbare Worthülsen über zukunftssichere Lösungen ohne überprüfbaren Faktengehalt oder technische Parameter.
Unkonkrete Werbesprache, deren hohe Entropie im Rauschen des Embedding-Raums untergeht und beim Retrieval verworfen wird.
„Planetengetriebe PG-40: 120 Nm, < 3 arcmin, η = 97 %.“
| Parameter | Wert | Norm / Bedingung |
|---|---|---|
| Nenndrehmoment | 120 Nm | Dauerbetrieb (S1) |
| Verdrehspiel | < 3 arcmin | Standard |
| Wirkungsgrad | 97 % | Volllast (3000 min⁻¹) |
Liefert dem Retrieval-Modell exakte Kennzahlen innerhalb der ersten 25 Token.
Direkte Übernahme der Tabelle in KI-Antworten.
Architektur, Tooling und automatisierte Qualitätskontrolle
Web-Labor (hackenberg.tech): Google Antigravity als primäres Designer- und Editor-Werkzeug
Redakteure tippen in WYSIWYG-Editoren; Datenbanken erzeugen überladenen DOM-Code und Sicherheitslücken.
Verschachtelte Strukturen und Plugins erzeugen überladenen DOM-Code und Sicherheitslücken.
Dynamisches Rendern bremst KI-Crawler durch langsame Server-Response-Times aus.
Agenturabhängigkeit für jedes Schema-Update und Plugin-Sicherheits-Patch.
Kein CMS: Ich instruiere Google Antigravity per natürlichem Sprach-Prompt als primäres Editor- und Architekturentool.
Der Agent schreibt reines semantisches Astro-HTML, MDX und JSON-LD direkt im Git.
Artikel, Folien und Schemas entstehen in Minuten statt monatelangen Agentur-Sprints.
Statische HTML-Auslieferung garantiert blitzschnelle Ladezeiten unter 100 ms für Crawler.
Wie `AGENTS.md` als verbindliche Leitplanke für autonome Coding-Agenten fungiert
Google Antigravity folgt einem strikt versionierten Regelwerk im Repository.
Der Agent darf keine Fakten oder Zahlen ohne explizite Primärquellen erfinden.
Jedes Dokument muss barrierefreie Cues und 100 % Zitationsparität aufweisen.
Vermeidung von Linux-Bash-Syntax, saubere PowerShell-Kommandos und strikte TypeScript-Typisierung.
Texte, Daten, Audio-Cues und Zitationen liegen direkt im Content-Verzeichnis neben dem Code.
Jede Text- und Code-Änderung ist per Commit-Historie auditierbar und revertierbar.
Vollständiger Verzicht auf angreifbare SQL-Datenbanken und dynamische Server-Schwachstellen.
Inhalte werden im Build-Schritt deterministisch zu statischen Seiten transformiert.
Werkzeuge für den Agenten: Der Unified Analytics MCP Server im praktischen Einsatz
Führt GSC-Suchdaten und Plausible-Engagement in einem konsolidierten Audit zusammen und korreliert organische Klickraten direkt mit realer Lesezeit und Scroll-Tiefe.
Identifiziert Striking-Distance-Keywords auf den Rängen 4 bis 15 zur gezielten Nachoptimierung von Snippets, Überschriften und semantischer Entitätsdichte im Fachartikel.
Prüft Zitierfähigkeit in generativen Overviews vor dem Release anhand von BLUF-Struktur, Faktendichte und JSON-LD-Parität.
Vom Prompt in Google Antigravity zum Audit-Bericht und visuellen Analytics-Overlays im Browser
Praxis-Tipp für den Live-Einsatz: Diesen strukturierten Prompt direkt in Google Antigravity einfügen – der Agent orchestriert selbstständig alle MCP-Tool-Aufrufe, verknüpft die Telemetriedaten und generiert in Sekunden den fertigen Maßnahmenplan.
Agent ruft über den Unified Analytics MCP get_page_audit und evaluate_aio_extractability auf.
Antigravity liefert einen priorisierten Audit-Bericht mit Scroll-Funnel und AIO-Score.
Wechsel in die Dev-Studio-Shell im lokalen Browser zur visuellen Seitenanalyse.
Live-Inspektion der visuellen Overlays für Scroll-Tiefe und Leser-Retention direkt auf der gerenderten Artikel-Oberfläche.
Die Ökonomie der Indexierung: Warum Latenzen und Timeouts Ihre Inhalte für KI-Bots unsichtbar machen
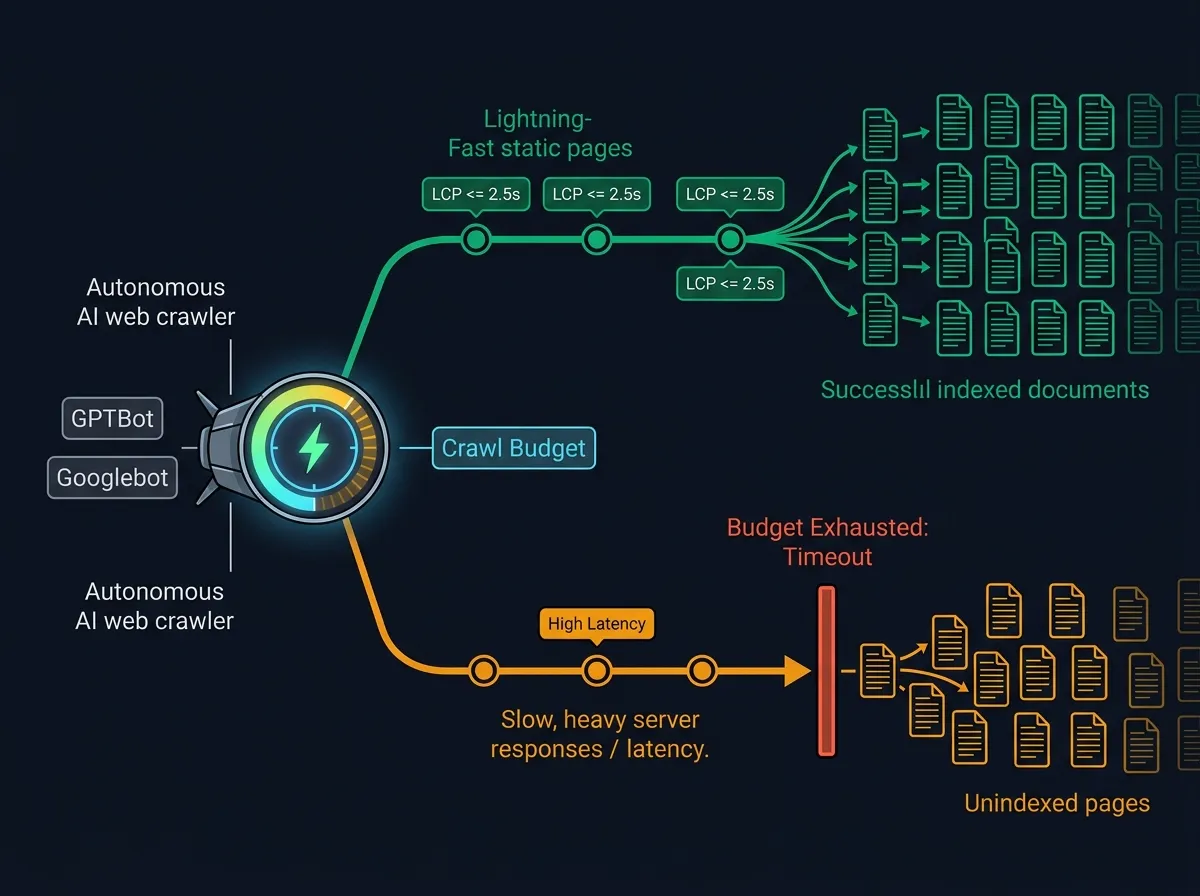
Google Search Central : Crawl-Kapazität sinkt bei langsamen Serverantworten drastisch ab.
Geringe Latenzen sichern, dass blitzschnelle statische HTML-Seiten hunderte Dokumente indexierbar machen.
Überlastete Backends führen dazu, dass hohe Serverlatenzen das Crawl-Rate-Limit drastisch drosseln.
Wird das Limit erreicht, führt die Timeout-Barriere zu unvollständiger Indexierung der Domain.
LCP, INP & CLS: Warum Millisekunden über die Aufnahme in den RAG-Index entscheiden
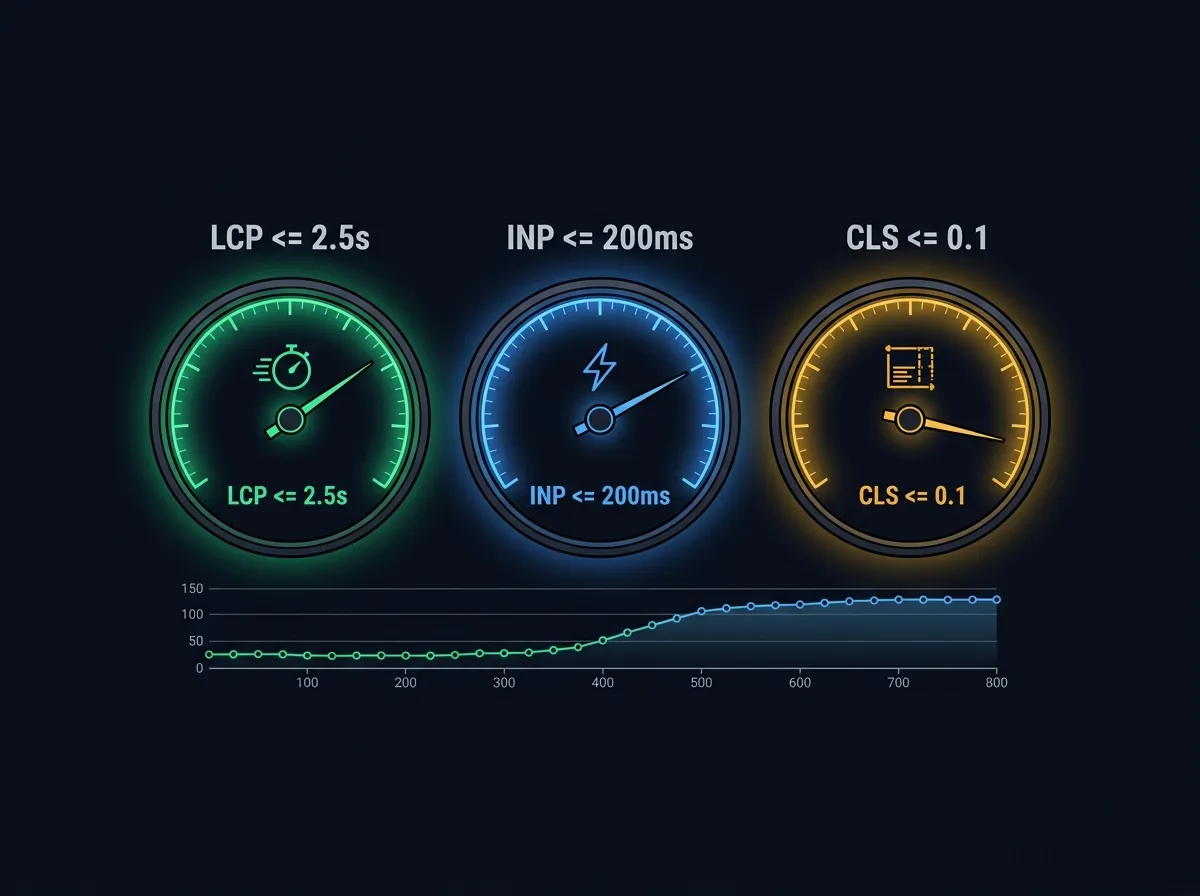
Google Web Vitals : Crawler von GPTBot und Perplexity brechen nach 2–3s ab.
Ein LCP unter zweieinhalb Sekunden sichert sofortige Extraktion des Hauptinhalts.
Ein INP unter zweihundert Millisekunden verhindert Script-Blockaden bei Interaktionen.
Ein CLS unter null Komma eins garantiert visuelle Stabilität ohne Layout-Ruckler.
Warum perfekte 100er-Scores die Eintrittskarte für KI-Crawler sind
Wenn eine Seite Ladezeitverzögerungen aufweist, brechen KI-Crawler den Render-Prozess vorzeitig ab.
$ npx lighthouse-mcp audit http://localhost:4321
✓ Performance: 100/100 (Speed Index: 0.6s)
✓ Accessibility: 100/100 (ARIA attributes valid)
✓ Best Practices: 100/100 (No deprecated APIs)
✓ SEO: 100/100 (Valid JSON-LD & meta title)
✓ All Quality Gates Passed. Proceeding to Edge Deploy.Erst wenn das lokale Audit via MCP-Protokoll fehlerfrei durchläuft, gibt die Pre-Commit-Pipeline das Edge-Deployment frei.
100 % DSGVO-Konformität ohne Cookie-Banner – mit semantischer Verweildauer- und Intent-Messung
window.setTimeout(…, 2000) bei ≥ 50 % Viewport-Sichtbarkeit
IntersectionObserver filtert flüchtige Bounces heraus und erfasst nur verweilende Fachleser.
Automatisierte Erfassung von Klick- und Dwell-Raten für Inhaltskarten im Viewport.
Erfasst Referral-Traffic aus Antwortsystemen.
Vollständig konform mit DSGVO, ePrivacy und TTDSG – ganz ohne lästiges Consent-Banner, sodass der erste Eindruck auf der Landingpage ungestört bleibt.
Verhindert Performance-Einbußen durch ultraleichten Skript-Footprint unter 1 KB und schützt damit nachhaltig Core Web Vitals sowie das Crawl-Budget technischer Dokumentationen.
Erzielt vollständige Messgenauigkeit ohne Opt-Out-Verluste, während klassische Cookie-Tracking-Suiten im europäischen B2B-Umfeld oft über 40 % aller Sitzungen verlieren.
Autorenautorität im vernetzten Wissensgraphen
Edelman-Studie: Warum Fachautorität auf LinkedIn Kaufentscheidungen und KI-Modelle steuert
Die Edelman-LinkedIn-Studie beweist: Fachbeiträge von Experten wiegen schwerer als Marketingmaterial.
Drei Viertel der B2B-Käufer recherchieren neue Anbieter nach starkem Thought Leadership.
Entscheider bewerten Kompetenz wesentlich glaubwürdiger über Fachbeiträge von Ingenieuren.
Sechzig Prozent der Entscheider zahlen nachweislich einen Preisaufschlag für klare Thought Leader.
Antwortsysteme wie Perplexity und Gemini nutzen Social Signals als Echtzeit-Validierung für Marken- und Personenreputation.
Persönliche Profile von Experten stärken die thematische Autorität des Unternehmens im LLM.
Social Thought Leadership verkürzt Vertriebszyklen vor dem ersten persönlichen Kontakt.
Über die Hälfte der Führungskräfte verbringt wöchentlich über eine Stunde mit LinkedIn-Fachinhalten.
Hinge & Edelman: Warum Fachexperten als Markenbotschafter das Unternehmenswachstum treiben
Studien mit über 1.000 B2B-Käufern und weltweiten Entscheidern : High-Growth-Unternehmen haben zu 75 % mehr Visible Experts.
Studie belegt: Persönliche Fachpräsenz führt direkt zu neuen Ausschreibungsgewinnen.
Edelman-Befund: Technical Experts genießen weit mehr Vertrauen als CEOs oder PR-Teams.
Die persönliche Reputation strahlt direkt und dauerhaft auf die Unternehmensmarke ab.
Weg vom starren PR-Maulkorb – hin zu agilen, ressourcenschonenden Enabler-Strukturen.
Fachstudien teilen mit 2–3 Sätzen Einordnung.
Befähigung der Experten zum Fachpublizieren.
15-Min.-Audio-Interview für die Redaktion.
Geprüfte Datenblöcke und Charts als Baukasten.
Schnelle Fachautorität: Branchenstudien und Normen mit 2–3 Sätzen Praxiseinordnung veredeln
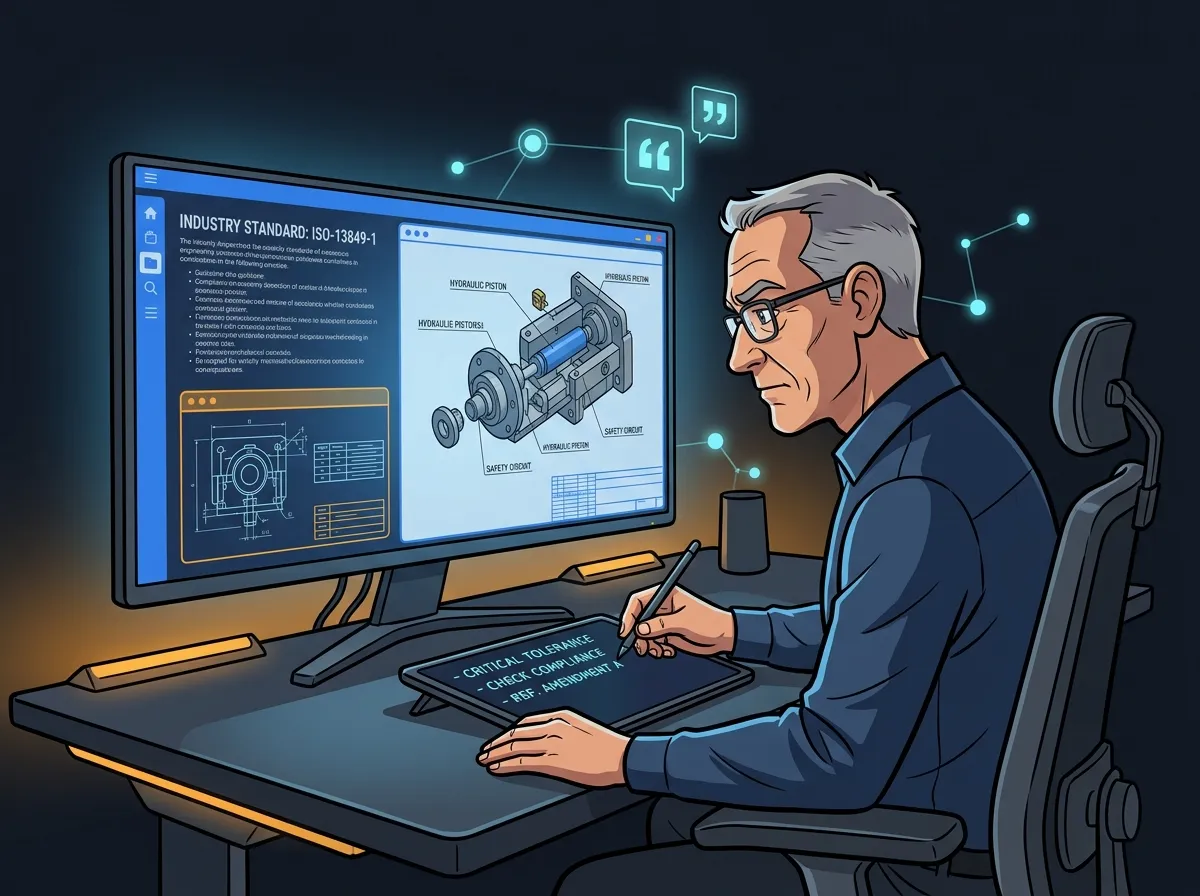
Keine leeren Marketing-Worthülsen: Das Kuratieren und Schärfen von Primärdaten senkt die Zeithürde auf 15 Minuten pro Woche.
Fachexperten müssen keine langen Essays schreiben, sondern teilen Normen, Whitepaper oder Studien.
Der unschätzbare Mehrwert liegt in 2–3 Sätzen Praxiseinordnung: Was bedeutet das konkret für Anlagenbetreiber?
Fachkommentare und Zitate liefern hochwertige semantische Kookkurrenzen für Perplexity und LLMs.
Befähigung statt Vorgabe: Wie Marketing Mitarbeiter zu eigenständigen Fachautoren entwickelt
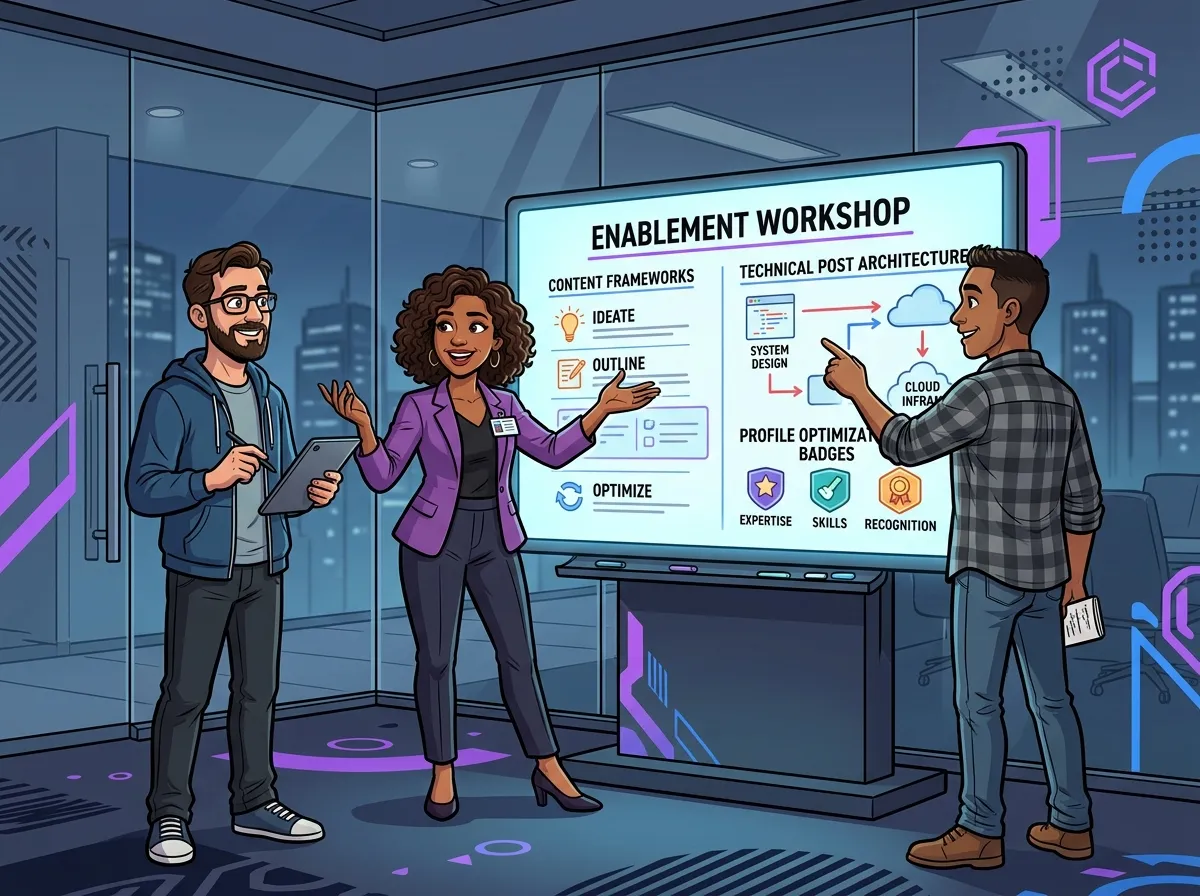
Authentizität lässt sich nicht vorschreiben: Marketing befähigt Fachexperten durch Methoden, Feedback und Algorithmen-Wissen.
Ingenieure lernen Profiloptimierung, Algorithmen-Dynamik und hook-starke Beitragsarchitekturen.
Marketing fungiert als vertrauensvoller Sparringspartner für Headlines, Struktur und Visuals vor dem Posten.
Keine PR-Floskeln: Die unverfälschte Fachsprache der Ingenieure erzeugt maximales Vertrauen im Markt.
Tech + MarCom auf Augenhöhe: 15-Minuten-Audio-Interviews als Hebel für Lead-Ingenieure und C-Level
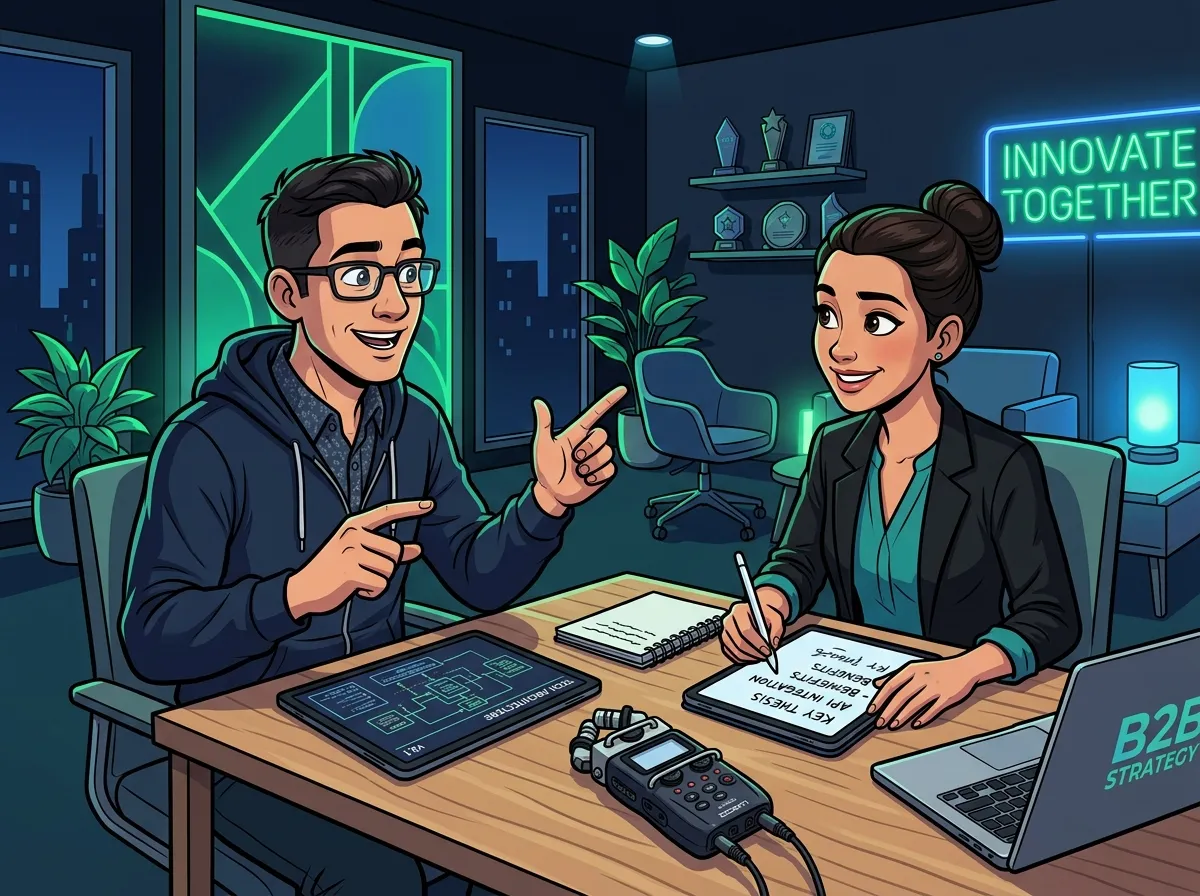
Kein Schreibdruck für den Experten: Das 15-minütige Audio-Debriefing extrahiert tiefes Fachwissen ohne Reibungsverluste.
Marketing stellt 3 präzise Leitfragen zum jüngsten Projekt-Meilenstein oder Kundenproblem via Audio-Aufnahme.
Kommunikatoren transkribieren und kaskadieren die Kernaussagen in 3–4 hook-starke Fachbeiträge und Karussells.
Der Experte kontrolliert alle technischen Fakten und Formeln vor der Freigabe – 100 % inhaltliche Kontrolle.
Wissensbaukasten für das Team: Geprüfte Datenblöcke, Charts und Visuals zur flexiblen Selbstbedienung
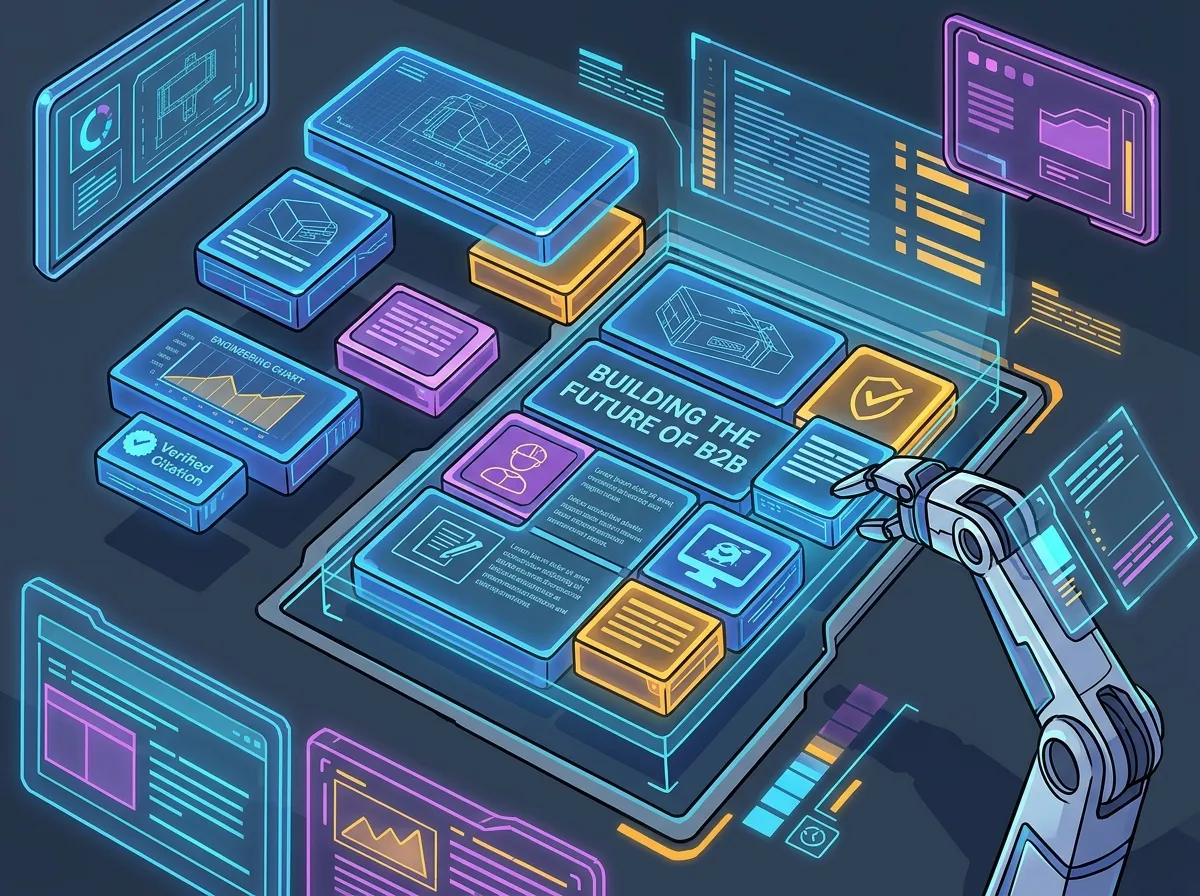
Kein Neuerfinden des Rades: Fachexperten nutzen vorbereitete, geprüfte Medienbausteine und fokussieren sich auf den Fachkommentar.
Marketing kuratiert freigegebene CAD-Renderings, Prüfstandskurven, Zitate und Benchmark-Zahlen im Intranet.
Ingenieure greifen flexibel auf relevante Bausteine zu und kombinieren sie mit ihrer aktuellen Kundenpraxis.
Geprüfte Kennzahlen schützen vor Falschangaben und garantieren konsistente Signale für LLM-Trainingsdaten.
Autorität ohne Klicklink: Wie Text-Kookkurrenzen Entitätsvertrauen in LLMs aufbauen
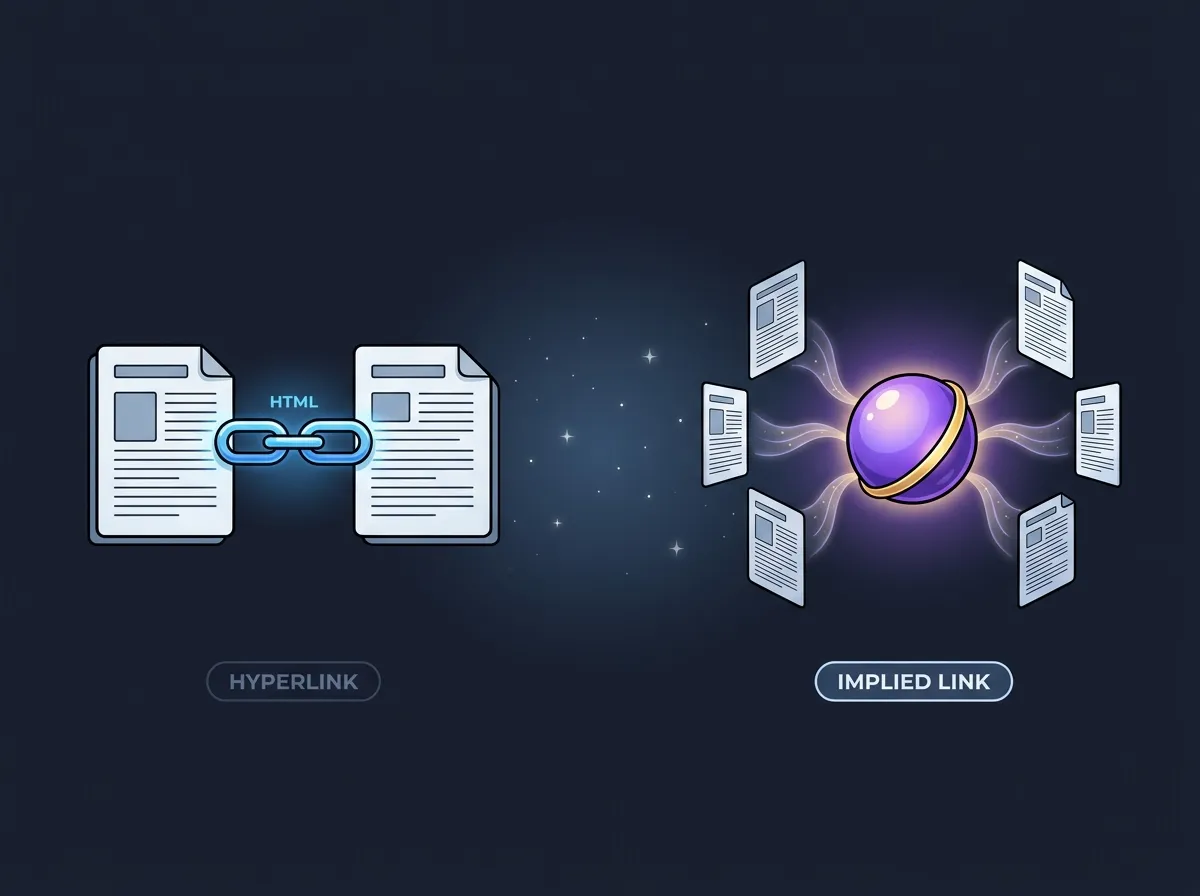
Panda & Roop : Unverlinkte Erwähnungen fließen als Referenzsignal in das Entitätsranking ein.
Verteilte Fachpublikationen bewirken, dass Erwähnungen in Branchenberichten den Vektor der Markenentität aufladen.
Qualitativer Kontext sorgt dafür, dass positiver Sentiment-Kontext die thematische Markenassoziation stärkt.
In der generativen Synthese führt dies dazu, dass LLMs bevorzugt Entitäten mit hoher Kookkurrenz-Dichte zitieren.
Authoritas-Studie: Warum Perplexity und SearchGPT LinkedIn und Foren als Anker nutzen
Authoritas : Bis zu 80 % der von LLMs zitierten Quellen stammen nicht aus den organischen Top-3-Suchergebnissen.
Antwortsysteme selektieren hochgradig strukturierte, fakten- und datendichte Textbausteine statt Fließtext.
BrightEdge : Perplexity und Gemini streuen Zitate über Fachnetzwerke, Foren und Portale.
Nur wenn Aussagen über mehrere unabhängige Plattformen hinweg konsistent sind, greift die Halluzinations-Schranke.
Reine Marketingtexte erzeugen Misstrauen – Community-Diskurs liefert Validierung.
LinkedIn-Kommentare und Fachforen liefern Echtzeit-Signale über Fachkonsens und praktische Anwendbarkeit.
Aussagen mit aktiver Fachdiskussion erhalten bei RAG-Retrievals ein signifikant höheres Vertrauens-Gewicht.
Perplexity und SearchGPT crawlen soziale Fachdiskussionen sekündlich für tagesaktuelle Verifikationen.
BrightEdge-Analyse: Warum YouTube mit 29,5 % die mit Abstand meistzitierte Quelle in AI Overviews ist
BrightEdge Research : YouTube ist die mit weitem Abstand meistzitierte Einzeldomain im generativen Suchraum.
In KI-Antworten wird YouTube 200-mal häufiger referenziert als Vimeo, TikTok oder LinkedIn-Video zusammen.
Besonders starkes Wachstum: Generative Engines ziehen Videoinhalte bevorzugt für Problemlösungen heran.
Gemini und GPT-4o fassen gesprochene Erklärungen direkt im Text der KI-Antwort zusammen.
95 % des Mittelstands lassen YouTube brachliegen – Ihre Chance auf KI-Monopole.
Marketing-Werbefilme bieten null Information Gain und werden von KI-Systemen komplett ignoriert.
Erklärungen von CAD-Modellen, Prüfstandsabläufen und Software-Workflows liefern unersetzliche Fakten.
Weil kaum ein Mitbewerber technische Erklärvideos baut, besetzen frühe Akteure die Video-Citations dauerhaft.
Transkripte, Video Chapters & Schema.org: Wie KIs exakte 20-Sekunden-Segmente als Antwort zitieren
Multimodale LLMs operieren auf Token-Ebene: Audio-Transkripte sind das Fundament.
Zeitstempel teilen Videos in diskrete semantische Sinneinheiten auf.
KIs springen direkt zur relevanten Sekundenmarke statt zum Gesamtvideo.
Käufer erhalten die exakte Erklärung des Ingenieurs sofort ohne Wartezeit.
Kein Zufall: Strukturierte VideoObject-Daten machen Videos für RAG-Pipelines maschinenlesbar.
Deklaration und Einbettung von VideoObject mit hasPart-Clips, startOffset und endOffset im JSON-LD direkt im Seiten-Header.
Einbindung von bereinigten Volltranskripten als Text-Property direkt im DOM.
Verknüpfung von YouTube-Video-IDs mit passenden Artikeln der eigenen Domain.
Thought Leadership, Video-Explainer und Open Source als lebender E-E-A-T-Beweis
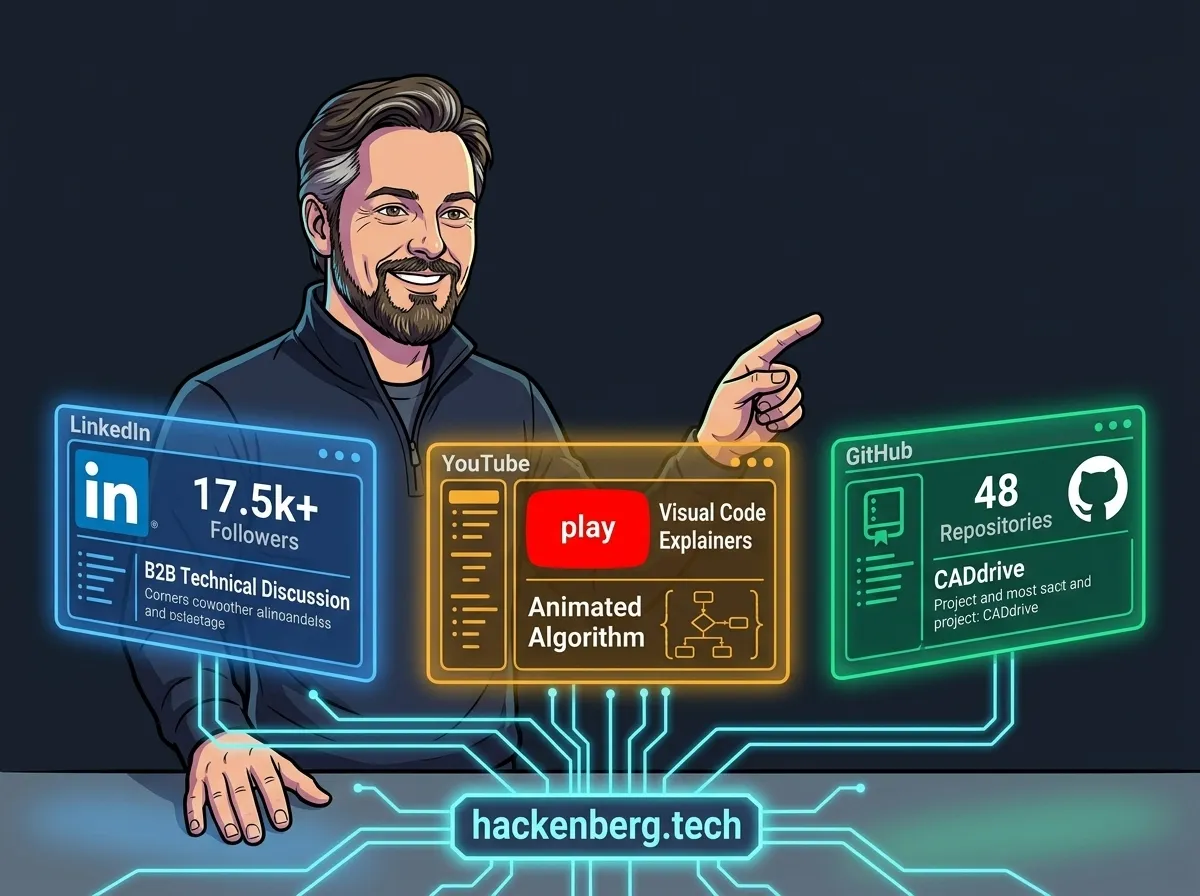
Keine anonyme Corporate-Präsenz, sondern ein synergetischer Verbund aus Expertise, Code und Reichweite .
17.500+ Follower und C-Level-Reichweite für Architektur-Diskurse und Industriekooperationen.
46 Videos mit Visual Explainers zu Algorithmen und Simulationen als multimodales Signal.
48 Repositories mit 142 Sternen (Flaggschiff CADdrive: 31 Sterne) als nachprüfbarer Proof of Work.
Rückbindung aller Kanäle an hackenberg.tech, im Wissensgraph über sameAs zu einer Entität verschmolzen.
Hub-and-Spoke-Prinzip: Website als Faktenanker und Social Media als Reichweitenverstärker
Die Website als kanonische Single Source of Truth – Social Media als Distributionskanal.
Detaillierte Fachartikel, Spezifikationen und Messungen leben exklusiv auf der eigenen Domain.
Unternehmensprofile auf LinkedIn, YouTube und Branchenportalen werden über sameAs-URIs bidirektional verknüpft.
Umfassender Primärcontent zerlegt Fachwissen in LinkedIn-Karussells und Zitate.
Best Practices und Software für professionelle Industrie-Kommunikation.
Plattformübergreifendes Scheduling und zentrales Kampagnen-Management für Industrieunternehmen.
Detailliertes Tracking von Mitarbeiter-Reichweiten und Corporate Influencing Metriken.
Unterstützung bei der Kernbotschaften-Aufbereitung aus technischen Primärstudien.
Vom Business Case zur operativen Umsetzung
Traffic-Verteilung 2026: 9,5 Milliarden monatliche Besuche auf generativen Plattformen
Globale Traffic-Analyse von 9,5 Milliarden monatlichen KI-Besuchen .
B2B-Entscheider konsultieren mehrere Modelle parallel zur Lieferantenauswahl.
Technische Einkäufer starten ihre Recherche in ChatGPT und Perplexity.
Führend für Code- und Systemanalysen.
Nur Google verliert 50 % der KI-Käufer.
Gartner & Opollo Studien 2026: Rep-free Recherche, KI-Shortlists & 14,2% Conversion-Benchmark
Wandel der Beschaffung durch KI .
Fast jeder zweite Einkäufer erstellt initiale Shortlists via Sprachmodelle.
Zwei Drittel bevorzugen vorab eine vollständig vertriebsfreie Recherche.
Vertriebsexperten validieren gezielt die von der KI generierten Empfehlungen.
Konversionsdaten von KI-Referrals .
KI-Referrals konvertieren mit 14,2 Prozent fünfmal stärker als Google-Suche.
Käufer haben vorab bereits präzise Spezifikationen durch die KI erhalten.
Weniger Gesamtklicks, aber drastisch höherwertige Vertriebskontakte und RFPs.
Vom Share of Voice zum relativen Anteil in generativen Kaufberatungen
Prüfung über standardisierte industriespezifische Kaufberatungs-Prompts in Modell-Panels.
Jede Nennung ohne Hyperlink festigt die Gewichtung im Modell und erhöht Empfehlungen.
Winner-Takes-Most-Dynamik: Anders als klassische Suchergebnisseiten mit zehn blauen Links nennen generative Kaufberatungen meist nur zwei bis drei favorisierte Anbieter – wer durch saubere GEO-Strukturierung die höchste Fakten-, Quellen- und Entitätsdichte im Fachkorpus liefert, dominiert die KI-Antwortsynthese überproportional.
Entscheidungsmatrix zwischen GEO-Startups und etablierten SEO-Suiten
Spezialisiert auf tägliches Prompt-Tracking über ChatGPT, Perplexity & Gemini.
Tägliche automatisierte Auswertung von Kaufberatungs-Prompts in Modell-Panels.
Deckt exakt auf, bei welchen Fragen Konkurrenten zitiert werden.
Hohe monatliche SaaS-Abogebühren bei noch fragmentiertem Tool-Markt.
Verknüpfen klassisches Keyword- und Backlink-Crawling mit generativen SERP-Snapshots.
Erkennt sofort, welche Suchergebnisse von KI-Boxen dominiert werden.
Erfasst und bewertet Unlinked Brand Mentions und Markenzitate im Netz.
Nahtlose Einbettung in einem etablierten Gesamtsystem ohne Tool-Bruch.
Die Zwei-Geschwindigkeiten-Architektur: SAP behalten und Astro-Edge vorschalten
Bestehende Unternehmenssysteme bleiben unangetastet: TYPO3, WordPress, Pimcore oder SAP ERP.
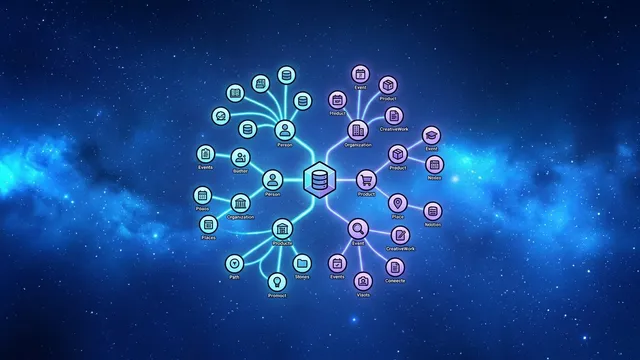
Schlanke Headless API aggregiert Produkte und Normen. Generiert automatisch den Schema.org @graph.
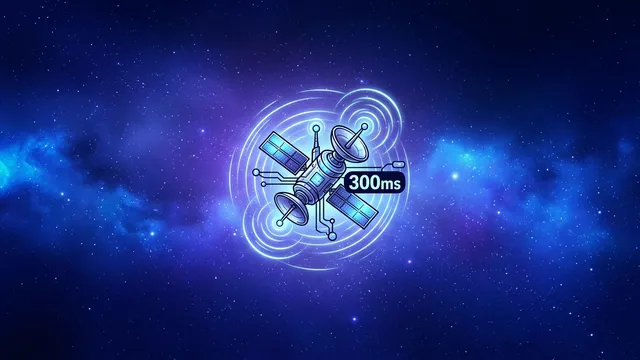
Hochoptimierte Auslieferung an CDN-Knoten mit Ladezeiten unter 300 Millisekunden für KI-Crawler.
Der geschlossene Regelkreis: Vom KI-Zitationsverlust über autonome Agenten ins CRM
Tool registriert Zitationsverlust bei Schlüssel-Prompt in ChatGPT oder Perplexity.
KI-Agent analysiert Quellcode, ergänzt Spezifikationen und schärft den BLUF-Antwortblock.
Fachexperte prüft den Git-Pull-Request via Human-in-the-Loop Sicherheit.
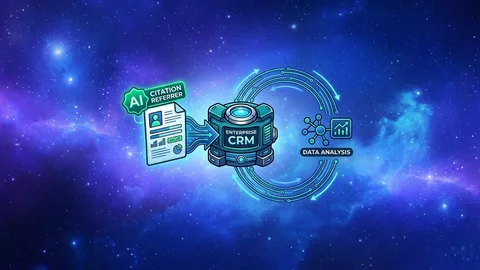
Neuer Lead trifft im CRM mit Zitations-Referrer ein und schließt den Regelkreis.
Messbare Zitationsmuster: Was Authoritas und Bain & Company für Entscheider nachweisen
Analyse von Tausenden generativer SERP-Abfragen .
Über 62 Prozent der zitierten Quellen stammen nicht aus den Top-3-Suchtreffern.
Modelle bevorzugen maschinenlesbare Produktdatenblätter und FAQs gegenüber Fließtext.
Fachspezifische Anbieter erzielen signifikante Zitationsgewinne gegenüber Generalisten.
Wie KI-Agenten Marketing und Vertrieb verändern .
Achtzig Prozent der Nutzer nutzen KI-Zusammenfassungen für mindestens 40 % der Suchen.
Klassischer Website-Traffic sinkt um 15 bis 25 Prozent bei Standard-Suchanfragen.
Recherche, Vergleich und Shortlist verschmelzen in einer einzigen KI-Interaktion.
Die drei goldenen Leitregeln für Geschäftsführer, Marketingleiter und Architekten
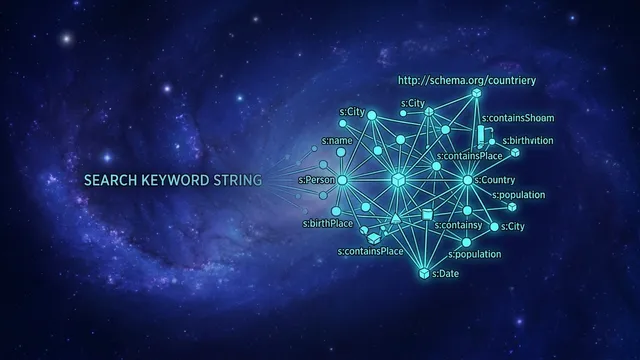
Bauen Sie Wissensgraphen statt Keyword-Friedhöfe. Eindeutige Schema.org-URIs verankern Ihre Produkte im Modellwissen.
Automatisieren Sie die Qualitätssicherung mit MCP-Dev-Agenten. Keine fehlerhaften Seiten mehr auf dem Edge-Server.
Liefern Sie proprietäre Primärdaten und Messungen. Nur einzigartiges, verifiziertes Wissen wird von LLMs zitiert.
In drei aufeinander aufbauenden Phasen zur zukunftssicheren GEO-Architektur im Mittelstand
Share of Model mit 50 Kern-Prompts ermitteln. Schema.org-Validierung durchführen. Wettbewerber-Zitationen erfassen.
Autorenprofile mit Wikidata/ORCID verknüpfen. Top-10-Produktseiten nach dem BLUF-Prinzip überarbeiten. MCP-Dev-Agenten testen.
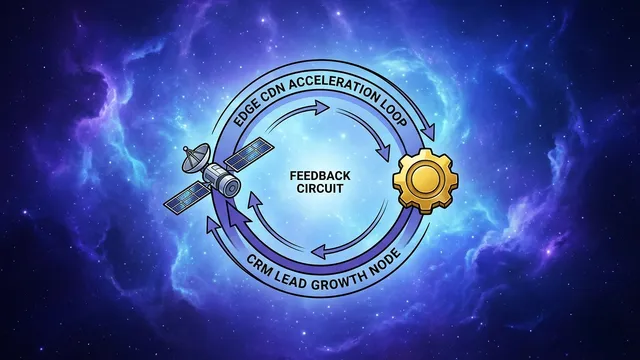
Zwei-Geschwindigkeiten-Edge-Layer aufsetzen. Zitations-Monitoring etablieren und CRM-Lead-Attribution automatisieren.
Die Kernfragen für maschinenlesbare Sichtbarkeit und Wissensgraphen
Spüren Sie in Ihrem Unternehmen bereits den Rückgang von organischem Klick-Traffic durch KI-Overviews?
Welche Governance-Anforderungen bestehen beim Einsatz lokaler autonomer Entwickler-Agenten?
Wer übernimmt im Betrieb künftig die Verantwortung für semantische Wissensgraphen?
Professor für Informatik und Industriesysteme
FH Oberösterreich · Campus Wels
Academic citations & source materials