In unserer fortlaufenden Beitragsreihe zur Websichtbarkeit im Zeitalter generativer Sprachmodelle haben wir die Evolution von klassischem SEO hin zu modernen Standards schrittweise analysiert: von den theoretischen Grundlagen und 4 Dimensionen moderner Sichtbarkeit (SEO, GEO, AEO, AIO) über die empirische Studienlage zu Zitationshebeln und Zero-Click-Suchen bis hin zu den industriellen Anforderungen im B2B-Bereich und dem vierstufigen GEO-Reifegradmodell.
In jenem Reifegradmodell markiert Level 4 den entscheidenden Schritt: die Transformation von manuell gepflegten Inhalten hin zu einem geschlossenen, agentenfähigen Regelkreis. Doch genau hier stießen Entwickler und Autoren bisher an eine methodische Mauer: das ROI-Paradoxon in der Zero-Click-Ökonomie und die strikte Datensilo-Bildung bestehender Analysewerkzeuge.
In diesem Beitrag überführen wir die Theorie in die betriebliche Praxis. Wir stellen die Architektur unseres eigens entwickelten, quelloffenen Unified Analytics MCP Servers vor: wie er Google Search Console und die datenschutzfreundliche Open-Source-Plattform Plausible Analytics deterministisch zusammenführt, Rohdaten vor dem Kontext-Inject token-effizient aggregiert und autonomen Coding-Agenten (wie Antigravity oder Claude Code) acht mächtige Werkzeuge für automatische Inhaltsaudits, Graph-Analysen und Pre-Commit-Prüfungen an die Hand gibt.
1. Das Dilemma isolierter Datensilos: Warum SEO und Web-Analytics bisher getrennt waren
Klassische Suchmaschinenoptimierung und Web-Analytics operieren in der Praxis in zwei getrennten Welten, die ohne mühsame manuelle Tabellenkalkulationen nicht miteinander kommunizieren können.
Suchmaschinenbetreiber liefern über die Google Search Console (GSC) wertvolle Einblicke in die vorgelagerte Nachfrage: Welche Suchbegriffe (Queries) tippen Nutzer ein? Wie oft erscheint ein URL-Snippet in den Suchergebnissen (Impressions)? Welche Position nimmt die Seite im Ranking ein, und wie oft wird geklickt (CTR)? Doch sobald der Besucher auf den Link klickt, reißt der Datenstrom der Search Console vollständig ab. GSC hat keinerlei Kenntnis darüber, ob der Nutzer 5 Sekunden oder 10 Minuten auf der Seite verweilt, ob er den Artikel komplett liest oder sofort frustriert abspringt (Bounce Rate).
Web-Analyseplattformen wie Plausible Analytics erfassen hingegen exakt dieses nachgelagerte Nutzerverhalten: tatsächliche Besucherzahlen, Sitzungsdauer, Scrolltiefen und Konversionen – und das im Falle von Plausible ohne invasive Tracking-Cookies und vollkommen DSGVO-konform. Doch Plausible weiß aufgrund moderner Referrer-Policies und verschlüsselter Suchen nicht, über welche konkreten Suchanfragen der Besucher auf die jeweilige Seite gelangte.
| Analysedimension | Google Search Console (GSC) | Plausible Analytics | Vereinte Sicht (Unified Analytics) |
|---|---|---|---|
| Erfasste Phase | Vor dem Klick (Suchmaschine / SERP) | Nach dem Klick (Auf der Website) | Vollständige Customer Journey |
| Kern-Metriken | Queries, Impressions, Klicks, Ranking-Position | Unique Visitors, PageViews, Bounce Rate, Visit Duration | Opportunity-Score, Engagement-Validierung |
| Stärke | Exakte Intention & Sichtbarkeitspotenziale | Reale Interaktionsqualität & Leseverhalten | Ganzheitliche Inhaltsbewertung |
| Schwäche | Blind für Nutzerverhalten nach dem Klick | Blind für konkrete Suchbegriffe und Rankings | Benötigt deterministischen Join-Layer |
Wer Inhaltsentscheidungen isoliert auf Basis von GSC-Impressionen trifft, optimiert oft an den realen Leserinteressen vorbei. Wer nur auf PageViews in Plausible schaut, übersieht sogenannte Striking-Distance-Chancen (Suchbegriffe auf den Positionen 4 bis 15, die mit minimalen semantischen Justierungen auf Platz 1 steigen könnten).
2. Wie funktioniert die Systemarchitektur des Unified Analytics MCP Servers?
Der Unified Analytics MCP Server ist ein spezialisierter Microservice auf Basis von TypeScript und dem Model Context Protocol (MCP), der als Brücke zwischen KI-Coding-Assistenten, der Google Search Console API und der Plausible REST API fungiert.
Statt einem LLM gigantische Rohdatenmengen aus CSV-Exporten oder unfiltrierten JSON-Dumps in das Prompt-Fenster zu kippen, verlagert der MCP-Server die Rechenlast, Filterung und Aggregation vollständig auf die lokale Laufzeitumgebung. Über das standardisierte Protokoll empfängt das Sprachmodell ausschließlich präzise, token-optimierte Antworten.
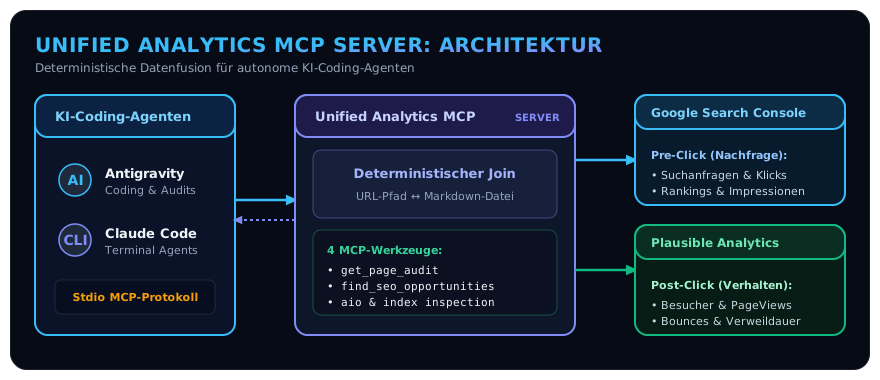
Deterministischer Pfad- und URL-Normalizer
Die größte Herausforderung beim Zusammenführen heterogener Datenquellen liegt in der Identifikation des gemeinsamen Schlüssels. Google Search Console liefert absolute, kanonische URLs (https://hackenberg.tech/posts/mein-artikel/), während Plausible relative Pfade (/posts/mein-artikel) protokolliert. Unser Normalizer vereinheitlicht Trailing Slashes, Protokolle und Domain-Präfixe deterministisch, sodass Suchanfragen und Verweildauer exakt auf denselben Markdown-Quelldateien im Astro-Repository abgebildet werden.
3. Die acht MCP-Werkzeuge im praktischen Überblick
Unser Server stellt dem KI-Agenten eine modulare Suite aus acht fokussierten Werkzeugen zur Verfügung, die sowohl analytische Telemetrie-Aufgaben als auch statische Inhalts-, Graph- und Git-Prüfungen abdecken. Das folgende UML-Klassendiagramm spezifiziert die primäre Schnittstelle (UnifiedAnalyticsMcpServer) mit ihren Methodensignaturen und Eingabeparametern:
View Diagram Source
---
title: "Schnittstellendefinition des Unified Analytics MCP Servers"
caption: "UML-Klassendiagramm der 8 MCP-Tools mit typisierten Parametern und Rückgabetypen nach Model Context Protocol Standard."
---
classDiagram
  class UnifiedAnalyticsMcpServer {
    +get_page_audit(path: string, period: PeriodEnum) UnifiedPageAudit
    +find_seo_opportunities(period: PeriodEnum, min_impressions: number, limit: number) OpportunitiesResult
    +inspect_url_index_status(urlOrPath: string) UrlInspectionDetails
    +evaluate_aio_extractability(target: string) AioEvaluationResult
    +scan_aio_readiness(collection: string, maxScore: number, limit: number) AioScanSummary
    +audit_internal_linking(targetPath: string, minIncomingLinks: number) InternalLinkAudit
    +audit_serp_snippets(collection: string, checkGscKeywords: boolean) SerpSnippetAudit
    +diff_aio_impact(target: string, baseRef: string) AioDiffResult
  }

  class PeriodEnum {
    <<enumeration>>
    last_7_days
    last_14_days
    last_28_days
    last_90_days
  }

  UnifiedAnalyticsMcpServer ..> PeriodEnum : uses
In den folgenden Abschnitten betrachten wir jedes der vier Werkzeuge im Detail und analysieren die jeweiligen Datenstrukturen der Rückgabeobjekte.
1. get_page_audit: 360-Grad-Analyse einzelner Pfade
Führt eine ganzheitliche 360-Grad-Prüfung für eine bestimmte Seite oder ein URL-Muster durch. Das Werkzeug verknüpft die wichtigsten organischen Suchbegriffe (Top Queries nach Klicks und Impressionen) direkt mit den realen Besuchszahlen, der Absprungrate und der durchschnittlichen Verweildauer der letzten 30 Tage.
View Diagram Source
---
title: "Datenmodell von UnifiedPageAudit"
caption: "UML-Klassendiagramm des UnifiedPageAudit-Ergebnisobjekts mit deterministisch verknüpften GSC- und Plausible-Kennzahlen."
---
classDiagram
  class UnifiedPageAudit {
    +string path
    +string fullUrl
    +string period
    +GscMetricSummary gsc
    +PlausiblePageMetrics plausible
    +AuditAssessment assessment
  }

  class GscMetricSummary {
    +number clicks
    +number impressions
    +number ctr
    +number position
    +GscQueryMetric[] topQueries
  }

  class GscQueryMetric {
    +string query
    +number clicks
    +number impressions
    +number ctr
    +number position
  }

  class PlausiblePageMetrics {
    +number visitors
    +number pageviews
    +number bounceRate
    +number visitDuration
  }

  class AuditAssessment {
    +string status
    +string[] notes
  }

  UnifiedPageAudit *-- GscMetricSummary
  UnifiedPageAudit *-- PlausiblePageMetrics
  UnifiedPageAudit *-- AuditAssessment
  GscMetricSummary *-- GscQueryMetric
2. find_seo_opportunities: Heuristische Potenzialerkennung
Implementiert datengestützte Heuristiken, um ungenutzte Hebel im Content-Bestand automatisch zu identifizieren:
- Striking-Distance-Keywords: Suchanfragen auf durchschnittlichen Ranking-Positionen zwischen 4.0 und 15.0 mit hoher Impression-Zahl. Hier lohnt sich eine Schärfung von Überschriften (
<h2>) und Meta-Snippets. - High-Bounce-Performers: Seiten mit starkem Such-Traffic, aber über 75% Absprungrate. Hier fehlt meist ein sofortiges direktes Antwort-Muster (Answer-First) am Textanfang.
- Hidden Champions: Artikel mit außergewöhnlich langer Verweildauer (> 2,5 Minuten), die jedoch in Google kaum Impressionen erhalten und gezielte interne Verlinkungen aus Pillar-Artikeln benötigen.
View Diagram Source
---
title: "Datenmodell von OpportunitiesResult"
caption: "UML-Klassendiagramm des Opportunity-Ergebnisobjekts zur Priorisierung von Content-Hebelwirkungen."
---
classDiagram
  class OpportunitiesResult {
    +string period
    +number minImpressions
    +number totalFound
    +SeoOpportunity[] opportunities
  }

  class SeoOpportunity {
    +string path
    +OpportunityType type
    +string priority
    +string title
    +string description
    +GscMetricSummary gsc
    +PlausiblePageMetrics plausible
    +string suggestedAction
  }

  class OpportunityType {
    <<enumeration>>
    striking_distance
    high_bounce_performer
    hidden_champion
    low_ctr_high_impression
  }

  OpportunitiesResult *-- SeoOpportunity
  SeoOpportunity ..> OpportunityType : typed by
3. inspect_url_index_status: Live-Indexierungsdiagnose
Kommuniziert direkt mit der Google URL Inspection API. Das Tool prüft live, ob eine Seite im Google-Index gelistet ist, wann der Googlebot sie zuletzt gecrawlt hat, ob die kanonische URL vom Crawler akzeptiert wurde und ob Rich-Snippet-Strukturen fehlerfrei erkannt wurden.
View Diagram Source
---
title: "Datenmodell von UrlInspectionDetails"
caption: "UML-Klassendiagramm des Google URL Inspection Prüfobjekts mit kanonischem Status und Crawl-Metadaten."
---
classDiagram
  class UrlInspectionDetails {
    +string url
    +string inspectionVerdict
    +string coverageState
    +string indexingState
    +string robotsTxtState
    +string pageFetchState
    +string googleCanonical
    +string userCanonical
    +string[] sitemap
    +string[] referringUrls
    +string lastCrawlTime
    +string mobileUsabilityVerdict
    +string[] rawIssues
  }
4. evaluate_aio_extractability: Lokale GEO- und Answer-Engine-Prüfung
Ein rein lokales, extrem schnelles Prüfwerkzeug, das Markdown-Dokumente (src/content/**) vor dem Veröffentlichen parst. Es misst:
- Die Answer-First-Dichte: Steht unter zentralen
##-Überschriften sofort ein prägnanter Definitionssatz (40–55 Wörter) ohne Floskeln? - Die Struktur-Dichte: Werden Vergleiche in Tabellen (
| ... |) und Prozessschritte in nummerierten Listen geführt, die von generativen Engines (ChatGPT, Perplexity) bevorzugt zitiert werden? - Das Vorhandensein valider Frontmatter-Metadaten und barrierefreier Diagramm-Captions.
View Diagram Source
---
title: "Datenmodell von AioEvaluationResult"
caption: "UML-Klassendiagramm des AIO-Evaluationsmodells zur Bestimmung der Zitationswahrscheinlichkeit in KI-Overviews."
---
classDiagram
  class AioEvaluationResult {
    +string target
    +string sourceFile
    +number score
    +AioBreakdown breakdown
    +string[] recommendations
  }

  class AioBreakdown {
    +DirectAnswerCheck directAnswerParagraphs
    +ElementCheck tables
    +ElementCheck structuredLists
    +QuestionHeadingCheck questionHeadings
    +SchemaCheck schemaStructuredData
    +SummaryLengthCheck conciseSummaryLength
  }

  class DirectAnswerCheck {
    +number count
    +boolean passed
    +string[] examples
  }

  class ElementCheck {
    +number count
    +boolean passed
  }

  class QuestionHeadingCheck {
    +number count
    +boolean passed
    +string[] headings
  }

  class SchemaCheck {
    +boolean detected
    +string[] types
  }

  class SummaryLengthCheck {
    +number avgWordsPerFirstParagraph
    +boolean passed
  }

  AioEvaluationResult *-- AioBreakdown
  AioBreakdown *-- DirectAnswerCheck
  AioBreakdown *-- ElementCheck
  AioBreakdown *-- QuestionHeadingCheck
  AioBreakdown *-- SchemaCheck
  AioBreakdown *-- SummaryLengthCheck
5. scan_aio_readiness: Flächenhafter Batch-Content-Scanner
Während die Einzelprüfung für gezielte Pre-Commit-Checks konzipiert ist, erfordert die Content-Strategie eines gesamten Repositories mit über 130 Artikeln einen flächendeckenden Scan. scan_aio_readiness iteriert rekursiv über definierte Sammlungen (posts, visualizations, courses), berechnet den Gesamtdurchschnitt und liefert eine nach Optimierungsbedarf aufsteigend sortierte Prioritätenliste.
View Diagram Source
---
title: "Datenmodell von AioScanSummary"
caption: "UML-Klassendiagramm des Batch-Scan-Ergebnisobjekts zur Priorisierung unzureichend optimierter Inhaltsseiten."
---
classDiagram
  class AioScanSummary {
    +number totalScanned
    +number averageScore
    +number highReadinessCount
    +number mediumReadinessCount
    +number lowReadinessCount
    +AioPageSummary[] results
  }

  class AioPageSummary {
    +string target
    +string sourceFile
    +number score
    +number tables
    +number questionHeadings
    +number directAnswers
    +string[] recommendations
  }

  AioScanSummary *-- AioPageSummary
6. audit_internal_linking: Graph-Analyse & Backlink-Matching
Generative Suchmaschinen und traditionelle Crawler bewerten thematische Autorität maßgeblich über die interne Linktopologie. audit_internal_linking parst alle relativen Markdown-Verlinkungen im gesamten Projekt, deckt verwaiste Seiten (Orphan Pages mit weniger als zwei eingehenden Links) auf und löst das Dilemma von Hidden Champions: Für eine Ziel-URL durchsucht das Werkzeug alle übrigen Fachartikel nach semantisch verwandten Keywords und schlägt sofort konkrete Spender-Absätze mit Kontext-Snippets für organische Querverweise vor.
View Diagram Source
---
title: "Datenmodell von InternalLinkAudit"
caption: "UML-Klassendiagramm der internen Linkgraphen-Analyse mit verwaisten Seiten und Keyword-Spender-Empfehlungen."
---
classDiagram
  class InternalLinkAudit {
    +number totalInternalLinks
    +number totalUniquePages
    +OrphanPage[] orphanPages
    +LinkingOpportunity[] linkingOpportunities
  }

  class OrphanPage {
    +string path
    +string sourceFile
    +number incomingLinksCount
  }

  class LinkingOpportunity {
    +string targetPath
    +string donorPath
    +string donorFile
    +string[] matchedKeywords
    +string snippetContext
  }

  InternalLinkAudit *-- OrphanPage
  InternalLinkAudit *-- LinkingOpportunity
7. audit_serp_snippets: SERP- & Snippet-Hygiene
Die Klickrate auf den Suchergebnisseiten entscheidet darüber, ob gewonnene Rankings auch in tatsächliche Leser konvertieren. audit_serp_snippets validiert Seitentitel (< 60 Zeichen) und Meta-Beschreibungen (140–160 Zeichen) gegen visuelle Truncation-Grenzen. Bei konfigurierter Google Search Console prüft das Tool zusätzlich, ob die tatsächliche Hauptsuchanfrage im Seitentitel verankert ist, um Keyword-Relevanzverluste automatisch zu verhindern.
View Diagram Source
---
title: "Datenmodell von SerpSnippetAudit"
caption: "UML-Klassendiagramm der Snippet- und Längenprüfung mit GSC-Keyword-Inklusionsabgleich."
---
classDiagram
  class SerpSnippetAudit {
    +number totalAudited
    +number issuesCount
    +SerpSnippetPageReport[] pagesWithIssues
  }

  class SerpSnippetPageReport {
    +string path
    +string sourceFile
    +string title
    +string description
    +number titleLength
    +number descriptionLength
    +SerpSnippetIssue[] issues
    +string topGscQuery
    +boolean hasTopGscQueryInTitle
  }

  class SerpSnippetIssue {
    +string field
    +string issue
    +string message
    +number currentLength
    +string recommendedRange
  }

  SerpSnippetAudit *-- SerpSnippetPageReport
  SerpSnippetPageReport *-- SerpSnippetIssue
8. diff_aio_impact: Git-Delta-Validierung vor dem Commit
Um den Netto-Effekt einer Inhaltsüberarbeitung objektiv messbar zu machen, vergleicht diff_aio_impact den aktuellen Stand einer Datei gegen eine beliebige Git-Revision (standardmäßig HEAD). Es weist neben dem exakten Punktegewinn (z. B. 50 -> 95 (+45 Punkte)) detailliert aus, wie viele Direct Answers, Spezifikationstabellen und W-Fragen durch die Bearbeitung netto hinzugewonnen wurden.
View Diagram Source
---
title: "Datenmodell von AioDiffResult"
caption: "UML-Klassendiagramm des Vorher-Nachher-Vergleichs gegen Git-Revisionen zur präzisen Qualitätsvalidierung."
---
classDiagram
  class AioDiffResult {
    +string target
    +string baseRef
    +number scoreBefore
    +number scoreAfter
    +number scoreDelta
    +number directAnswersDelta
    +number tablesDelta
    +number questionHeadingsDelta
    +number listsDelta
    +AioEvaluationResult before
    +AioEvaluationResult after
  }
4. Token-Effizienz: Warum Aggregation vor dem Prompting entscheidend ist
In modernen Entwicklungs- und Pair-Programming-Szenarien ist das Kontextfenster von Sprachmodellen ein kostbares Gut. Ein naiver Ansatz, der rohe JSON-Antworten mit tausenden Zeilen unbereinigter Suchbegriffe in den Agenten-Prompt injiziert, führt zu drei gravierenden Problemen:
- Context Bloat: Der Chat-Verlauf füllt sich rasch mit irrelevanten Datenzeilen.
- Attention Dilution: Große Sprachmodelle verlieren bei ausufernden Kontextmengen an logischer Präzision (Lost in the Middle).
- Kosten & Latenz: Unnötige Ein- und Ausgabetoken verlangsamen die Reaktionszeit der IDE spürbar.
Der Unified Analytics MCP Server filtert, gruppiert und bewertet die Rohdaten bereits auf Knotenebene vor. Statt 5.000 Einzelsuchanfragen erhält der Agent eine kompakte Liste der 10 wirkungsvollsten Keywords mitsamt berechneter Metrik-Differenzen.
5. Vollständige Integration in den Entwicklungs-Workflow
Um den MCP Server nahtlos in moderne Multi-Agenten-Umgebungen wie Antigravity oder Claude Code einzubinden, haben wir die Architektur auf zwei Pfeilern aufgesetzt:
- Standardisiertes Package-Management:
Über ein dediziertes Setup-Skript in unserer Root-package.jsonwird der MCP-Server inscripts/mcp-unified-analytics/sauber gebaut und global im System verlinkt:npm run setup:mcp - Deklarative Agenten-Instruktionen:
In den zentralen Agenten-Richtlinien unsererAGENTS.mdist die Nutzung des Servers vor jeder Inhaltsüberarbeitung und vor jedem Commit verbindlich vorgeschrieben.
// Auszug aus der Tool-Implementierung: Striking Distance Heuristik
export function calculateStrikingDistance(queries: SearchConsoleRow[]) {
  return queries
    .filter((q) => q.position >= 4.0 && q.position <= 15.0 && q.impressions >= 100)
    .sort((a, b) => b.impressions - a.impressions)
    .slice(0, 10)
    .map((q) => ({
      query: q.keys[0],
      impressions: q.impressions,
      currentPosition: Math.round(q.position * 10) / 10,
      ctr: Math.round(q.ctr * 1000) / 10 + '%',
    }));
}
6. Fazit & Ausblick: Der geschlossene Regelkreis für KI-Sichtbarkeit
Mit dem Unified Analytics MCP Server schließt sich der Kreis, den wir vor Wochen mit den theoretischen Fundamenten der KI-Sichtbarkeit begonnen haben. Technische Autoren und Software-Architekten müssen Content-Optimierung nicht mehr im Blindflug oder anhand veralteter Ranking-Tabellen betreiben.
Indem wir Google Search Console und Plausible über das Model Context Protocol direkt in die Entwicklungsumgebung integrieren, wird die Optimierung für generative Suchmaschinen (GEO), Antwortmaschinen (AEO) und traditionelle Crawler (SEO) zu einem messbaren, automatisierten und reproduzierbaren Standardprozess.